

Wikipedia · einfach zusammengefasst · Stand
Entscheidungsbaum
Entscheidungsbäume (englisch: decision tree) sind geordnete, gerichtete Bäume, die der Darstellung von Entscheidungsregeln dienen. Die grafische Darstellung …
Inhalt5 Abschnitte
Grundidee und Aufbau
Entscheidungsbäume (englisch: decision tree) sind geordnete, gerichtete Bäume, mit denen Entscheidungsregeln dargestellt werden. Als Baumdiagramm zeigen sie hierarchisch aufeinanderfolgende Entscheidungen. Sie sind wichtig überall dort, wo Datenobjekte automatisch klassifiziert werden oder aus Erfahrungswissen formale Regeln entstehen sollen.
Ein Entscheidungsbaum dient zur automatischen Klassifikation von Datenobjekten und damit zur Lösung von Entscheidungsproblemen. Er kann auch genutzt werden, um formale Regeln übersichtlich darzustellen. Jeder Entscheidungsbaum besitzt einen Wurzelknoten, beliebig viele innere Knoten und mindestens zwei Blätter. Jeder Knoten steht für eine logische Regel; jedes Blatt steht für eine Antwort auf das Entscheidungsproblem.
Die Regeln sind in ihrer Komplexität und Bedeutung zunächst nicht beschränkt. Bei binären Entscheidungsbäumen kann jeder Regelausdruck nur einen von zwei Werten annehmen. Alle Entscheidungsbäume lassen sich in binäre Entscheidungsbäume überführen.
Einsatzgebiete sind unter anderem Stochastik, maschinelles Lernen, Data-Mining, Entscheidungstheorie, ärztliche Entscheidungsfindung einschließlich Notfallmedizin sowie Business-Rule-Management-Systeme (BRMS). In der Stochastik können Entscheidungsbäume als Wahrscheinlichkeitsbäume bedingte Wahrscheinlichkeiten veranschaulichen.
Klassifikation und Lernverfahren
Um mit einem Entscheidungsbaum ein einzelnes Datenobjekt zu klassifizieren, beginnt man am Wurzelknoten und geht entlang des Baumes nach unten. An jedem Knoten wird ein Attribut abgefragt. Die Antwort bestimmt, welcher Folgeknoten gewählt wird. Dieser Vorgang läuft weiter, bis ein Blatt erreicht ist. Das Blatt enthält die Klassifikation. Ein Baum beantwortet grundsätzlich genau eine Fragestellung.
Entscheidungsbäume können von Fachleuten manuell erstellt oder mit Verfahren des maschinellen Lernens automatisch aus gesammelten Erfahrungswerten induziert werden. Induktion bedeutet hier, dass aus Beispieldaten ein allgemeines Regelwerk erzeugt wird. Dafür wird ein Trainingsdatensatz benötigt, in dem für jedes Objekt die Klassifikation des Zielattributs bekannt ist.
Die Induktion erfolgt meist rekursiv im Top-down-Prinzip: Bei jedem Schritt wird das Attribut gesucht, mit dem sich die Trainingsdaten in Bezug auf das Zielattribut am besten klassifizieren lassen. Als Maße dafür können Entropie-Maße, der Gini-Index oder andere Kriterien verwendet werden. Danach werden die Daten anhand dieses Attributs aufgeteilt. Auf die entstehenden Teilmengen wird dasselbe Verfahren wieder angewendet, bis in jeder Teilmenge nur noch Objekte mit einer Klassifikation enthalten sind. Am Ende beschreibt der Entscheidungsbaum das Erfahrungswissen des Trainingsdatensatzes in formalen Regeln.
Die so erzeugten Bäume können anschließend andere Datensätze automatisch klassifizieren oder als Regelwerk interpretiert und ausgewertet werden.
Algorithmen und Bewertung
Algorithmen zur automatischen Induktion von Entscheidungsbäumen folgen grundsätzlich demselben rekursiven Top-down-Prinzip. Sie unterscheiden sich vor allem darin, nach welchen Kriterien sie Attribute und Werte an den Knoten auswählen, wann sie den Induktionsprozess abbrechen und ob sie bereits berechnete Äste oder ganze Bäume nachträglich optimieren.
Eine ältere Algorithmusfamilie sind die CHAIDs (Chi-square Automatic Interaction Detectors) von 1964. Sie können Bäume auf Grundlage diskreter Attribute erzeugen. CARTs (Classification And Regression Trees) erweitern CHAIDs vor allem dadurch, dass sie reellwertige Attribute verarbeiten können. Dafür verwenden sie ein Teilungs-Kriterium, auf Englisch split-criterion, mit dem reellwertige Attribute in diskrete Kategorien aufgeteilt werden. Außerdem führen CARTs Optimierungsstrategien wie Pruning ein. Pruning bedeutet, dass ein Baum nachträglich gekürzt wird, um ihn übersichtlicher oder robuster zu machen. Der ID3-Algorithmus und seine Nachfolger C4.5 und C5.0 zählen formal zur Familie der CARTs, werden aber häufig als eigene Gruppe betrachtet, weil sie zahlreiche neue Optimierungsstrategien einführen.
Die Fehlerrate eines Entscheidungsbaumes ist die Anzahl der inkorrekt klassifizierten Datenobjekte im Verhältnis zu allen Datenobjekten eines Datensatzes. Sie wird entweder auf den Trainingsdaten oder besser auf einer von den Trainingsdaten getrennten Menge möglichst korrekt klassifizierter Datenobjekte ermittelt. Je nach Anwendungsbereich kann es wichtiger sein, falsch positive oder falsch negative Klassifikationen besonders niedrig zu halten. In der Notfallmedizin ist es zum Beispiel weniger schädlich, einen gesunden Patienten zu behandeln, als einen kranken Patienten nicht zu behandeln. Die Wirksamkeit eines Entscheidungsbaumes hängt deshalb auch vom Kontext ab.
Regeln, Vorteile und Grenzen
Eine mögliche Klassifikation eines Entscheidungsbaumes kann in Disjunktiver Normalform dargestellt werden. Dabei betrachtet man alle Blätter dieser Klassifikation und ihre Pfade zurück zum Wurzelknoten. Für jeden Pfad werden die Bedingungen der Entscheidungsknoten mit „und“ verknüpft, also in Konjunktion gesetzt. Die so entstehenden Terme werden anschließend mit „oder“ verknüpft, also in Disjunktion gesetzt.
Der große Vorteil von Entscheidungsbäumen ist ihre Interpretierbarkeit. Sie sind gut erklärbar und nachvollziehbar. Benutzer können das Ergebnis auswerten und wichtige Attribute erkennen. Das ist besonders nützlich, wenn grundlegende Eigenschaften der Daten vorher nicht bekannt sind. Entscheidungsbäume können verständliche Regeln erzeugen, benötigen für die Klassifizierung wenig Berechnung, können kontinuierliche und kategoriale Variablen verarbeiten und zeigen, welche Felder für Vorhersage oder Klassifizierung besonders wichtig sind.
Ein Nachteil ist die oft geringere Klassifikationsgüte in reellwertigen Datenräumen. Wegen ihres diskreten Regelwerks schneiden Entscheidungsbäume bei vielen realen Klassifikationsproblemen statistisch betrachtet etwas schlechter ab als andere Techniken wie Künstliche Neuronale Netze oder Support-Vektor-Maschinen. Sie liefern also verständliche Regeln, aber nicht immer die bestmögliche Qualität.
Weitere Probleme entstehen, wenn Bäume sehr groß werden. Dann verliert ein Mensch leicht den Überblick, und der Baum kann sich zu stark an den Trainingsdatensatz anpassen. Diese Überanpassung führt dazu, dass neue Datensätze fehlerhaft klassifiziert werden. Pruning-Methoden können die Größe begrenzen, etwa durch eine maximale Tiefe oder eine Mindestanzahl von Objekten pro Knoten. Entscheidungsbäume eignen sich außerdem weniger für Schätzaufgaben, bei denen ein kontinuierlicher Wert vorhergesagt werden soll. Bei vielen Klassen und wenigen Trainingsbeispielen sind sie fehleranfällig. Auch das Trainieren kann rechenintensiv sein, weil an jedem Knoten Kandidaten für Aufteilungen geprüft, sortiert und manchmal kombiniert werden müssen.
Erweiterungen und Anwendungen
Eine wichtige Erweiterung sind Entscheidungswälder, also Mengen von Entscheidungsbäumen. Sie sollen die Klassifikationsgüte verbessern. Entscheidungswälder gehören im maschinellen Lernen zu den Ensemble-Techniken. Die Grundidee ist, dass ein einzelner Entscheidungsbaum nicht optimal sein muss, die Mehrheitsentscheidung mehrerer geeigneter Bäume aber eine bessere Klassifikation liefern kann. Verbreitete Methoden zur Erzeugung solcher Wälder sind Boosting, Bagging und Arcing. Ein Nachteil ist, dass die Gesamtheit der Regeln für Menschen deutlich schwerer zu interpretieren ist als bei einem einzelnen Baum.
Entscheidungsbäume können auch mit neuronalen Netzen kombiniert werden. Ineffiziente Äste eines Baumes können durch neuronale Netze ersetzt werden, um eine höhere Klassifikationsgüte zu erreichen. Entscheidungsbäume brauchen für ihre Induktion nicht so viele Trainingsdaten wie neuronale Netze, können aber ungenauer sein, besonders wenn sie klein sind. Neuronale Netze klassifizieren genauer, benötigen aber mehr Trainingsdaten. TBNN (Tree-Based Neural Network) übersetzen Regeln aus Entscheidungsbäumen in neuronale Netze.
Praktisch sind Entscheidungsbäume in verschiedenen Programmen verfügbar, zum Beispiel in R, Scikit-learn (XGBoost), SPSS und SAS. SPSS und SAS verwenden wie viele Data-Mining-Software-Pakete den CHAID-Algorithmus. Ein Beispiel für die Anwendung ist Kundenklassifikation: Eine Bank möchte mit einer Direktmarketing-Aktion einen neuen Service verkaufen und nur Haushalte ansprechen, bei denen ein Entscheidungsbaum anhand demografischer Variablen gute Erfolgsaussichten erkennt. Dieser Prozess heißt Data Segmentation oder Segmentation Modeling.
Lernvideos zu Entscheidungsbaum
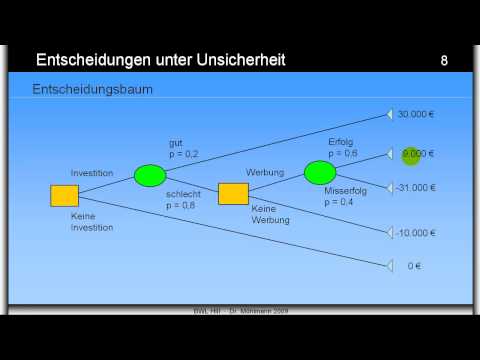 9:14
Entscheidungsbaum - ABWL - Entscheidung unter Unsicherheit
onlinedozent · 61.170 Aufrufe
 5:54
Der Entscheidungsbaum - eine bewährte Strategie bei schwierigen Entscheidungen
Entscheidungsnavigator · 8.734 Aufrufe
 6:43
Entscheidungsbaum einfach erklärt – Predictive Analytics mit Beispiel
numiqo - Deutsch · 658 Aufrufe