Wikipedia · einfach zusammengefasst · Stand
K-Means-Algorithmus
Ein k-Means-Algorithmus ist ein Verfahren zur Vektorquantisierung, das auch zur Clusteranalyse verwendet wird. Dabei wird aus einer Menge von ähnlichen …
Inhalt6 Abschnitte
Grundidee und Ziel
Der k-Means-Algorithmus ist ein Verfahren zur Vektorquantisierung und Clusteranalyse. Er teilt ähnliche Datenobjekte in eine vorher festgelegte Anzahl k von Gruppen, sogenannte Cluster. Das Verfahren ist weit verbreitet, weil es einfach ist und Clusterzentren schnell findet. Es bevorzugt allerdings Cluster mit geringer Varianz und ungefähr gleicher Größe.
Ziel ist eine Aufteilung des Datensatzes in k Partitionen, bei der die Summe der quadrierten Abweichungen aller Datenpunkte von ihren jeweiligen Cluster-Schwerpunkten möglichst klein ist:
J = ∑ᵢ₌₁ᵏ ∑ₓⱼ∈Sᵢ ‖xⱼ − μᵢ‖²
Dabei bezeichnet xⱼ einen Datenpunkt, Sᵢ den i-ten Cluster und μᵢ dessen Schwerpunkt. Die Zielfunktion beruht auf der Methode der kleinsten Quadrate; deshalb wird auch von Clustering durch Varianzminimierung gesprochen. Da ‖xⱼ − μᵢ‖² die quadrierte euklidische Distanz ist, wird jeder Punkt dem nächstgelegenen Cluster-Schwerpunkt zugeordnet. Der Schwerpunkt ist das arithmetische Mittel der Punkte eines Clusters.
Die Suche nach der optimalen Lösung ist NP-schwer. In der Praxis verwendet man daher Näherungsverfahren wie die Heuristiken von Lloyd oder MacQueen. Die Ähnlichkeit zum EM-Algorithmus ist groß.
Ablauf des Standardverfahrens
Als Standardverfahren gilt meist der Lloyd-Algorithmus. Er arbeitet in drei Schritten:
• Initialisierung: Aus dem Datensatz werden k zufällige Mittelpunkte m₁⁽¹⁾, …, mₖ⁽¹⁾ gewählt.
• Zuordnung: Jeder Datenpunkt wird dem Cluster zugeordnet, dessen Mittelpunkt ihm nach der quadrierten euklidischen Distanz am nächsten liegt. Dadurch wird die Cluster-Varianz möglichst wenig erhöht. Geometrisch entstehen Zuordnungsgebiete in Form eines Voronoi-Diagramms.
• Aktualisierung: Für jeden Cluster wird sein Mittelpunkt als arithmetisches Mittel seiner Punkte neu berechnet:
mᵢ⁽ᵗ⁺¹⁾ = (1 / |Sᵢ⁽ᵗ⁾|) ∑ₓⱼ∈Sᵢ⁽ᵗ⁾ xⱼ
Zuordnung und Aktualisierung werden wiederholt, bis sich die Zuordnungen beziehungsweise Mittelpunkte nicht mehr ändern. Im Pseudocode werden dazu in jeder Runde zunächst k leere Cluster erzeugt, alle Punkte dem jeweils nächsten Zentrum zugewiesen, neue Zentren berechnet und anschließend mit den bisherigen Zentren verglichen.
MacQueens Verfahren arbeitet anders: Es wählt die ersten k Elemente als Clusterzentren. Danach wird jedes weitere Element dem Cluster zugeordnet, bei dem es die Varianz am wenigsten erhöht; das betroffene Zentrum wird sofort aktualisiert. Obwohl dies ursprünglich vermutlich nicht vorgesehen war, lässt sich auch dieses Verfahren zur Verbesserung des Ergebnisses mehrfach durchlaufen.
Voraussetzungen und Grenzen
k-Means eignet sich nur für numerische Attribute, für die ein sinnvoller Mittelwert berechnet werden kann. Kategorien wie „Auto“, „LKW“ und „Fahrrad“ lassen sich nicht unmittelbar verwenden. Außerdem muss die Anzahl k grundsätzlich im Voraus bekannt sein. Sie kann experimentell bestimmt werden, doch die Kostenfunktion sinkt mit wachsendem k monoton und erlaubt daher allein keinen fairen Vergleich verschiedener Clusterzahlen. Der Silhouettenkoeffizient berücksichtigt sowohl den Abstand eines Punktes zum eigenen Cluster als auch die Abstände zu anderen Clustern und ermöglicht eine von k unabhängige Bewertung.
Das Verfahren setzt ungefähr gleich große Cluster voraus, weil es den Raum jeweils an der Mitte zwischen zwei Clusterzentren teilt. Der Datensatz sollte außerdem wenig Rauschen und wenige Ausreißer enthalten. Solche Punkte können die als Mittelwerte berechneten Zentren stark verschieben.
Das Ergebnis muss nicht die bestmögliche Lösung sein und hängt stark von den Startpunkten ab. Deshalb kann man mehrere Durchläufe mit unterschiedlichen Startwerten ausführen und die beste Lösung auswählen. Eine ungeeignete Wahl von k kann zu völlig anderen oder unintuitiven Ergebnissen führen.
Weitere Grenzen betreffen die Form der Daten:
• Überlappende oder nahtlos ineinander übergehende Gruppen können nicht zuverlässig getrennt werden.
• Wegen der Zuordnung zum jeweils nächsten Schwerpunkt findet k-Means nur konvexe Cluster. DBSCAN kann dagegen auch beliebig geformte, dichtebasierte Cluster erkennen.
• Hierarchische Cluster, also Gruppen mit einer inneren Clusterstruktur, werden nicht unterstützt; solche Strukturen können beispielsweise mit OPTICS gefunden werden.
• Jeder Punkt wird zwingend einem Cluster zugeordnet. Eine eigene Erkennung von Ausreißern oder „Noise“-Objekten fehlt. Möglich sind eine vorherige Rauschreduktion oder der Einsatz eines Verfahrens wie DBSCAN.
Varianten und Erweiterungen
Mehrere Varianten verändern die Initialisierung, die Datenstruktur oder das Optimierungskriterium. Der Filtering-Algorithmus verwendet einen k-d-Baum; andere Beschleunigungen nutzen die Dreiecksungleichung. Bisecting k-means startet mit k = 2 und teilt danach jeweils den größten Cluster, bis die gewünschte Anzahl erreicht ist. X-means beginnt ebenfalls mit k = 2, erhöht k aber nur, solange sich ein zusätzliches Kriterium wie das Akaike-Informationskriterium oder das bayessche Informationskriterium verbessert.
k-Means++ verbessert die Wahl der Startzentren:
• Das erste Zentrum wird zufällig aus den Objekten gewählt.
• Für jedes Objekt wird der Abstand D(x) zum nächstgelegenen bereits gewählten Zentrum bestimmt.
• Das nächste Zentrum wird zufällig gewählt, wobei die Auswahlwahrscheinlichkeit proportional zu D²(x) ist. Weit entfernte Objekte werden dadurch wahrscheinlicher ausgewählt.
• Die Berechnung und Auswahl werden wiederholt, bis k Zentren vorliegen. Anschließend läuft das gewöhnliche k-Means-Verfahren.
Der nachfolgende Algorithmus konvergiert gewöhnlich in wenigen Schritten. Laut Artikel sind die Ergebnisse so gut wie beim üblichen k-Means, während das Verfahren typischerweise fast doppelt so schnell ist.
Beim k-Median-Algorithmus wird für die Zuordnung die Manhattan-Distanz statt der euklidischen Distanz verwendet. Bei der Aktualisierung tritt der Median an die Stelle des Mittelwerts.
PAM („Partitioning Around Medoids“, Kaufman und Rousseeuw, 1990), auch k-Medoids genannt, wählt k tatsächlich vorhandene Objekte als Zentren, die Medoide. Alle Objekte werden dem nächsten Medoid zugeordnet. Danach werden mögliche Vertauschungen zwischen Medoiden und Nicht-Medoiden geprüft; übernommen wird die Vertauschung mit der kleinsten Summe der Distanzen oder Unähnlichkeiten. Dies wird wiederholt, bis sich die Medoide nicht mehr ändern. PAM ist nahezu deterministisch, weil pro Runde nur die beste Vertauschung ausgeführt wird, ist aber meist sehr langsam. Anders als k-Means minimiert es Distanzen statt Varianzen, kann beliebige Distanzfunktionen verwenden und konvergiert dennoch garantiert.
Typischer Durchlauf und Einsatz in Bildern
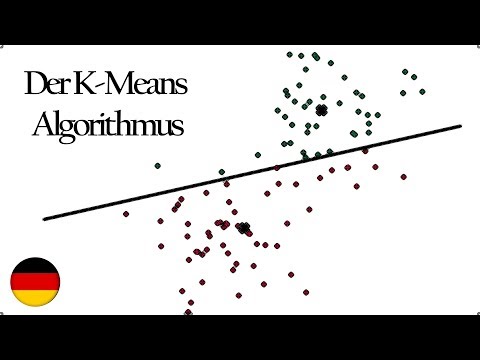
Ein typischer Durchlauf zur Bildung von drei Gruppen beginnt mit drei zufällig gewählten Clusterzentren. Anschließend wird jeder Datenpunkt dem nächstgelegenen Zentrum zugeordnet; die entstehenden Gebiete bilden ein Voronoi-Diagramm. Danach werden die Schwerpunkte der drei Cluster neu berechnet. Mit diesen neuen Zentren werden die Punkte erneut verteilt. Dieser Wechsel aus Zuordnung und Neuberechnung wird bis zur Konvergenz fortgesetzt.
In der Bildverarbeitung dient k-Means häufig der Segmentierung, also der Aufteilung eines Bildes in Bereiche. Die reine euklidische Distanz reicht dabei oft nicht aus; stattdessen können Abstandsfunktionen verwendet werden, die Pixelintensitäten und Pixelkoordinaten einbeziehen. Die Ergebnisse helfen unter anderem bei der Trennung von Vordergrund und Hintergrund sowie bei der Objekterkennung.
Entwicklung und verfügbare Software
Die Idee geht auf Hugo Steinhaus aus dem Jahr 1957 zurück. Lloyd schlug den heute meist als k-Means bezeichneten Standardalgorithmus ebenfalls 1957 für die Puls-Code-Modulation vor; veröffentlicht wurde er erst 1982 in einer Informatik-Zeitschrift. Er stimmt weitgehend mit Forgys 1965 veröffentlichter Methode überein. MacQueen verwendete 1967 erstmals den Ausdruck „k-means“, beschrieb aber einen anderen Algorithmus. Die Verfahren werden daher häufig falsch zugeordnet. Eine Variante von Hartigan und Wong vermeidet unnötige Distanzberechnungen, indem sie auch den Abstand zum zweitnächsten Mittelpunkt berücksichtigt.
k-Means und seine Varianten stehen in mehreren Open-Source-Programmen zur Verfügung. Dlib bietet eine Implementierung. ELKI enthält unter anderem Lloyds und MacQueens Verfahren, k-Means++, k-Medians, k-Medoids und PAM. GNU R bietet Varianten von Hartigan, Lloyd und MacQueen sowie zusätzliche Verfahren im Erweiterungspaket „flexclust“. OpenCV enthält eine für Bildverarbeitung optimierte Fassung einschließlich k-Means++-Initialisierung. Scikit-learn bietet k-Means, Elkans Variante und k-Means++; Weka enthält k-Means mit k-Means++-Initialisierung sowie X-means.