

Wikipedia · einfach zusammengefasst · Stand
Genetischer Code
Als genetischer Code wird die Weise bezeichnet, mit der die Nukleotidsequenz eines RNA-Einzelstrangs in die Aminosäurensequenz der Polypeptidkette eines …
Inhalt5 Abschnitte
Bedeutung und Ablauf der Übersetzung
Der genetische Code beschreibt, wie die Nukleotidsequenz eines RNA-Einzelstrangs in die Aminosäuresequenz einer Polypeptidkette und damit eines Proteins übersetzt wird. Er verbindet also die in DNA gespeicherte Erbinformation mit dem Aufbau von Proteinen. In seinen Grundzügen ist dieser Code bei allen bekannten Lebewesen gleich.
Für die Genexpression wird ein DNA-Abschnitt zunächst durch Transkription in RNA umgeschrieben. In eukaryoten Zellen kann die zunächst gebildete hnRNA durch Spleißen und RNA-Editing verändert und zur mRNA prozessiert werden. Die fertige mRNA wird aus dem Zellkern exportiert. An Ribosomen im Zytosol oder am endoplasmatischen Reticulum erfolgt die Translation: Die mRNA wird in 5′→3′-Richtung gelesen und in eine Polypeptidkette übersetzt. Anschließend können posttranslationale Modifikationen das Polypeptid verändern.
Nicht jede transkribierte RNA dient als Vorlage für ein Protein. Nicht-codierende DNA kann in RNAs umgesetzt werden, die nicht translatiert werden. Dazu gehören tRNAs und rRNAs, aber auch weitere meist kleine RNA-Formen, die beispielsweise Transkription, Translation, DNA-Reparatur, epigenetische Markierungen oder Funktionen des Immunsystems regulieren.
Codons, tRNAs und Proteinsynthese
Ein Codon ist ein Basentriplett, also eine Folge von drei Nukleobasen der mRNA, das für eine Aminosäure codieren kann. Da vier Basen möglich sind – Adenin (A), Guanin (G), Cytosin (C) und Uracil (U) – gibt es 4³ = 64 mögliche Codons. 61 codieren für die 20 kanonischen proteinogenen Aminosäuren, drei sind Stopcodons. Eine Codierung durch Zweiergruppen wäre nicht ausreichend, denn 4² = 16 mögliche Dupletts reichen nicht für 20 Aminosäuren.
Zum jeweiligen Codon passt das komplementäre Anticodon einer Transfer-RNA (tRNA). Jede tRNA trägt eine bestimmte Aminosäure; die Zuordnung entsteht bei ihrer Beladung durch eine Aminoacyl-tRNA-Synthetase. Im Ribosom bindet die passende tRNA an das Codon der mRNA. Ihre Aminosäure wird durch eine Peptidbindung an die vorherige Aminosäure angefügt. Die so entstehende Aminosäureabfolge ist die Primärstruktur eines Proteins.
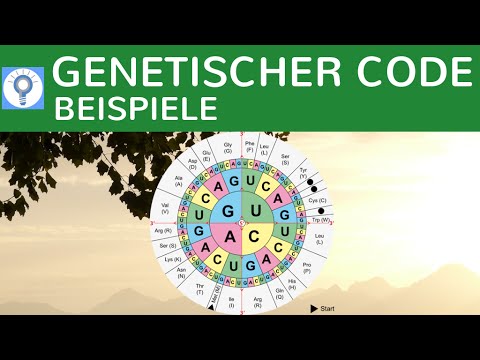
Beispiele des Standard-Codes sind GAU für Asparaginsäure (Asp) sowie UGU und UGC für Cystein (Cys). AUG codiert für Methionin (Met) und ist zugleich das wichtigste Startcodon. Welche AUG-Stelle als Start dient, erkennt das Ribosom an Signalen der benachbarten mRNA-Sequenz; außerdem sind Initiationssequenzen, -faktoren und eine spezielle Initiator-tRNA nötig. Seltener können auch ACG und CUG sowie in prokaryoten Zellen GUG und UUG als Startcodons dienen. Die erste Aminosäure ist meist Methionin, bei Bakterien und in Mitochondrien N-formyliertes Methionin.
UAA, UAG und UGA beenden normalerweise die Translation und heißen Stop- oder Terminationscodons. UGA kann unter bestimmten Bedingungen Selenocystein (Sec), die 21. proteinogene Aminosäure, codieren. Dafür sind eine besondere Sequenzumgebung, Cofaktoren und die spezielle tRNA^Sec erforderlich. Einige Archaeen und Bakterien können UAG mit spezieller tRNA^Pyl und Pyrrolysyl-tRNA-Synthetase als Pyrrolysin (Pyl), die 22. proteinogene Aminosäure, übersetzen.
Degeneration und Schutz vor Fehlern
Der genetische Code ist degeneriert: Mehrere unterschiedliche Codons können dieselbe Aminosäure bedeuten. So stehen über 60 Codons für etwa 20 bei der Translation eingebaute Aminosäuren zur Verfügung. Codons für dieselbe Aminosäure unterscheiden sich meist nur in einer Base, häufig in der dritten, „wackelnden“ Base. Diese Position wird bei der Translation besonders leicht falsch gelesen; oft bleibt bei einer Änderung dennoch dieselbe Aminosäure erhalten.
Diese Struktur macht den Code gegenüber Punktmutationen fehlertoleranter. Synonyme Mutationen verändern die Aminosäure nicht. Nichtsynonyme Mutationen führen häufig zu Aminosäuren mit ähnlichen Eigenschaften und sind daher eher konservative Substitutionen. Die mittlere Base eines Tripletts gibt den Charakter der Aminosäure oft weitgehend an: _ U _ steht für hydrophobe Aminosäuren, _ A _ für hydrophile; bei _ C _ treten ungeladene polare oder unpolare Aminosäuren auf. Geladene Seitenketten kommen bei _ G _ und _ A _ vor, negative Ladung nur bei _ A _. Änderungen in der ersten Position können besonders wichtig sein, weil sie eine Ladungsumkehr verursachen können, was für die Protein-Funktion dramatische Folgen haben kann.
Die Fehlertoleranz ist bedeutsam, weil Proteinstruktur und -funktion von Art, Anzahl und Reihenfolge der Aminosäuren abhängen. Wird bei einem Fehler eine Aminosäure ähnlichen Charakters eingebaut, beeinträchtigt dies die Funktion meist weniger als der Einbau einer sehr unähnlichen Aminosäure. Unter einer Million Zufallscodes sind hinsichtlich der Fehlertoleranz nur 100 besser als der tatsächliche Code; bei zusätzlicher Berücksichtigung typischer Mutations- und Lesefehler ist es nur 1 von 1 Million.
Universalität und Varianten
Die Universalität des Codes bedeutet, dass Lebewesen im Prinzip dieselbe genetische „Sprache“ verwenden: Information liegt in Nukleinsäuresequenzen vor, wird für Proteine in Tripletts gelesen, und ein bestimmtes Codon steht fast immer für dieselbe Aminosäure. Deshalb kann beispielsweise das Gen für menschliches Insulin in Bakterien eingeschleust werden, sodass diese Insulin produzieren. Unterschiede in der Codonverwendung zwischen Arten bedeuten nicht zwingend Unterschiede in der Häufigkeit der Aminosäuren.
Der Standard-Code ist jedoch nicht ausnahmslos gültig. Es werden inzwischen über dreißig Varianten genetischer Codes unterschieden. Besonders Organellen mit eigenem Genom zeigen Abweichungen: Für mitochondriale DNA sind über zehn Formen mitochondrialen Codes bekannt, die vom nukleären Code des Zellkerns abweichen; Plastiden besitzen ebenfalls einen eigenen Code.
Beispiele für Abweichungen sind: In Mitochondrien aller bisher untersuchten Organismen bedeutet UGA Tryptophan statt Stop. In Mitochondrien von Säugern steht AUA für Methionin und dient als Start, während AGC und AGU Stop statt Serin bedeuten. Bei Saccharomyces cerevisiae codieren CUU, CUC, CUA und CUG in Mitochondrien für Threonin statt Leucin. Bei einigen Candida-Arten steht CUG für Serin. Bei Wimpertierchen codiert UAG, oft auch UAA, für Glutamin; UGA kann manchmal Cystein bedeuten. In SR1-Bakterien kann UGA für Glycin stehen.
Darstellung in DNA-Daten und gezielte Erweiterung
DNA-Sequenzdatenbanken wie GenBank geben auch mRNA-Sequenzen nach einer historischen Konvention im DNA-Alphabet an: Sie verwenden T statt U. In Codetabellen bezeichnet die Zeile „AS“ die Aminosäuren im Ein-Buchstaben-Code; „M“ in der Zeile „Starts“ kennzeichnet Initiation und „*“ Termination. Varianten können sich ausschließlich in alternativen Start- oder Stopcodons unterscheiden.
Für die Entwicklung des genetischen Codes wird allgemein ein Übergang von einem ursprünglichen, mehrdeutigen Urcode zu einem wohldefinierten, „eingefrorenen“ Code mit 20 (+2) kanonischen Aminosäuren angenommen. Über den genauen Ablauf bestehen verschiedene Auffassungen. Darauf aufbauend gibt es Modelle, die mögliche „Eintrittspunkte“ für die Erweiterung des genetischen Codes mit synthetischen Aminosäuren vorhersagen.
Lernvideos zu Genetischer Code
 4:01
Genetischer Code - Code Sonne / Gensonne & Eigenschaften - Der genetische Code einfach erklärt
Die Merkhilfe · 355.621 Aufrufe
 5:38
Genetischer Code - Beispielaufgaben + Lösungen Code Sonne / Gensonne (Klausuren, Abitur, Prüfungen)
Die Merkhilfe · 321.087 Aufrufe
 4:17
Genetischer Code erklärt in nur 3 Minuten - Biologie kurz und knapp - Ixis Crash Kurs fürs BioAbi
Ixis Crash-Kurs fürs Bio-Abi · 9.251 Aufrufe
 4:48
Der Genetische Code | STARK erklärt
STARK Verlag · 142.531 Aufrufe