

Informatik · Klasse 11–13 · aktualisiert
k-Nächste-Nachbarn-Algorithmus einfach erklärt
Du lernst, wie kNN einen neuen Punkt per Abstand und Mehrheit einer Klasse zuordnet, warum k und Normalisierung zählen und wie man testet.
0 von 12 Aufgaben gelöst
Kurz gesagt
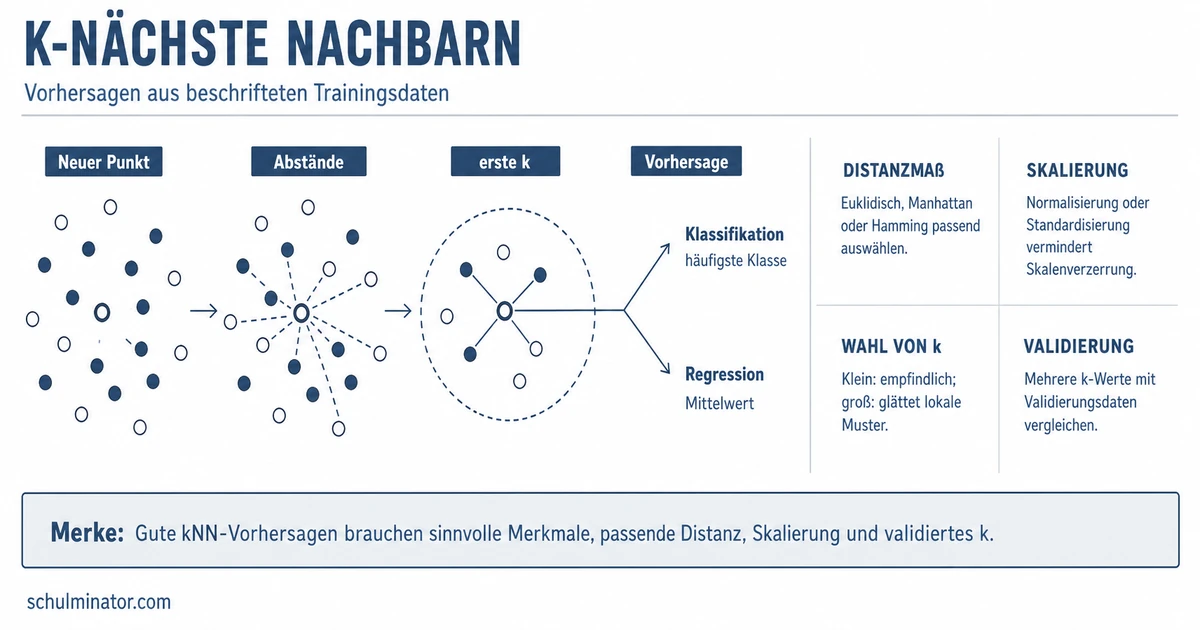
Der k-Nächste-Nachbarn-Algorithmus (kNN) ordnet einen neuen Punkt der Klasse zu, die unter seinen k nächsten, bereits beschrifteten Nachbarn am häufigsten vorkommt. Die Nähe misst man zum Beispiel mit dem euklidischen Abstand. Ob das gut funktioniert, prüft man an Testdaten.
Dein Handy sortiert E-Mails in „Spam“ und „kein Spam“. Wie entscheidet ein Programm so etwas bei einer neuen Nachricht? kNN macht es mit einer einfachen Idee: Es schaut, welchen bekannten Beispielen der neue Fall am nächsten ist. Hier lernst du, wie das geht und wie man die Qualität prüft.
Deine Lernziele
Hake ab, was du schon kannst. Löst du alle Aufgaben eines Abschnitts, hakt Mela das Ziel für dich ab.
4 Abschnitte
Beim überwachten Lernen bekommt ein Lernalgorithmus Datensätze, die zu jeder Eingabe einen passenden Ausgabewert enthalten. Solche Datensätze heißen markiert oder gelabelt. Ein Label ist also die bekannte richtige Antwort, zum Beispiel „Katze“ oder „Hund“ bei einem Bild.
kNN ist ein Klassifikationsverfahren. Das heißt: Es ordnet ein neues Objekt einer Klasse zu, zum Beispiel „Spam“ oder „kein Spam“. Dafür berücksichtigt es die k nächsten Nachbarn des neuen Objekts. Das sind die k nächsten Trainingsbeispiele, deren Klasse schon bekannt ist.
Das Lernen ist bei kNN sehr einfach: Es besteht aus simplem Abspeichern der Trainingsbeispiele. Das nennt man auch „lazy learning“ („träges Lernen“).
Definition
Label
Ein Label ist die bekannte richtige Antwort zu einem Datensatz, zum Beispiel „Spam“ oder „kein Spam“. Datensätze mit Labels heißen gelabelt oder markiert.
Beispiel: Bilder mit Labels
- 1Eingabe: ein Bild. Label: „Katze“ oder „Hund“.
- 2Ein Mensch hat zu jedem Trainingsbild das Label hinzugefügt.
- 3Ziel: Bei einem neuen Bild soll die Klasse möglichst richtig vorhergesagt werden.
Merke: kNN speichert die Trainingsbeispiele nur ab. Eine Vorhersage entsteht erst durch den Blick auf die k nächsten Nachbarn des neuen Punktes.
Teste dich
Um die Nähe zu messen, braucht man einen Abstand. Der euklidische Abstand zweier Punkte in der Ebene ist die Länge der Strecke, die sie verbindet, zum Beispiel mit einem Lineal gemessen. Mit Koordinaten rechnest du ihn mit dem Satz des Pythagoras: Du bildest die Unterschiede der beiden Koordinaten, quadrierst sie, addierst und ziehst die Wurzel. Es sind auch andere Abstandsmaße denkbar.
Für A = (a₁, a₂) und B = (b₁, b₂) gilt: d(A, B) = √((b₁ − a₁)² + (b₂ − a₂)²). Bei mehr Merkmalen kommt für jedes Merkmal ein weiterer Summand dazu.
So gehst du vor: Berechne den Abstand des neuen Punktes zu allen Trainingspunkten. Wähle die k Punkte mit den kleinsten Abständen. Zähle ihre Klassen. Der neue Punkt bekommt die Klasse, die unter diesen k Nachbarn am häufigsten vorkommt. Das ist die Mehrheitsentscheidung. Bei zwei Klassen kann ein ungerades k ein Unentschieden verhindern.
Definition
Euklidischer Abstand
Der euklidische Abstand zweier Punkte ist die Länge der Strecke, die sie verbindet. In der Ebene rechnest du ihn mit dem Satz des Pythagoras aus den Koordinaten.
Beispiel: Abstand von A und B
- 1A = (1, 1) und B = (5, 4)
- 2Unterschiede: 5 − 1 = 4 und 4 − 1 = 3
- 3d(A, B) = √(4² + 3²) = √25 = 5
Merke: Erst alle Abstände berechnen, dann die k kleinsten auswählen, dann die Klassen dieser k Punkte zählen.
Teste dich
Ist k klein gewählt, besteht die Gefahr, dass Rauschen in den Trainingsdaten die Klassifikationsergebnisse auf den Testdaten verschlechtert. Mit Rauschen sind einzelne ungewöhnliche oder fehlerhafte Datenpunkte gemeint. Bei k = 1 zählt nur der allernächste Nachbar.
Wird k zu groß gewählt, besteht die Gefahr, Punkte mit großem Abstand zum neuen Punkt in die Entscheidung einzubeziehen. Diese Gefahr ist insbesondere groß, wenn die Trainingsdaten nicht gleichverteilt vorliegen oder nur wenige Beispiele vorhanden sind. Bei nicht gleichmäßig verteilten Trainingsdaten kann man eine gewichtete Abstandsfunktion verwenden. Sie gibt näheren Punkten ein höheres Gewicht als weiter entfernten.
Zur Normalisierung: Merkmale mit einem kontinuierlichen Wertebereich werden in der Regel auf den Wertebereich zwischen 0 und 1 normalisiert. Kontinuierlich heißt: Die Werte können beliebige Zahlen in einem Bereich sein, zum Beispiel Längen. Man macht das, damit der Algorithmus Merkmale mit großen und mit kleinen Zahlenwerten gleich stark gewichtet. Eine Datennormalisierung kann die Genauigkeit von kNN erhöhen. Das ist keine Garantie.
Ausgedachtes Beispiel: Ein Merkmal hat Werte um 170 (Körpergröße in Zentimetern), ein anderes Werte von 1 bis 6 (Schulnote). Die Zahlen sind sehr verschieden groß. Nach der Normalisierung liegen beide zwischen 0 und 1.
Definition
Normalisierung
Normalisieren heißt hier: Die Werte eines Merkmals werden auf den Bereich zwischen 0 und 1 gebracht. So sollen Merkmale mit großen und kleinen Zahlenwerten gleich stark zählen.
Merke: Zu kleines k: Rauschen kann stören. Zu großes k: weit entfernte Punkte können mitentscheiden. Normalisierung kann die Genauigkeit erhöhen.
Teste dich
Um ein Verfahren fair zu bewerten, teilt man den Datensatz auf. Bei der Holdout-Methode gibt es einen Trainingsdatensatz, mit dem das System trainiert wird. Es gibt einen Testdatensatz, mit dem nach dem Training die Vorhersagequalität für unbekannte Daten überprüft wird. Und es gibt ein oder mehrere Validierungsdatensätze, falls eine Hyperparameteroptimierung geplant ist. Hyperparameter sind Einstellungen, mit denen man den Lernvorgang an die Aufgabe anpasst. Mit den Validierungsdaten prüft man, welche Einstellung gut passt. Die Testdaten trennt man vorher ab. Training und Test sollten dieselbe Verteilung der Daten repräsentieren.
Allgemein beim Lernen mit Beispieldaten kann man solche Einstellungen mit Validierungsdaten vergleichen. Das ist hier ein allgemeines Vorgehen, keine besondere Regel für kNN.
Warum nicht einfach mit den Trainingsdaten prüfen? Ein überangepasstes Modell gibt die Trainingsdaten korrekt wieder, weil es sie sozusagen „auswendig gelernt“ hat. Auf neuen Daten verallgemeinert es dann nicht mehr. Steigt der Fehler auf den Testdaten, während der Fehler auf den Trainingsdaten fällt, liegt möglicherweise eine Überanpassung vor.
| Datensatz | Wozu dient er? |
|---|---|
| Trainingsdaten | Mit ihnen wird das System trainiert. |
| Validierungsdaten | Sie helfen, Einstellungen des Verfahrens zu vergleichen. |
| Testdaten | Mit ihnen wird nach dem Training die Qualität für unbekannte Daten geprüft. |
Merke: Trainieren mit den Trainingsdaten, Einstellungen mit den Validierungsdaten vergleichen, die Qualität am Ende mit den vorher abgetrennten Testdaten prüfen.
Teste dich
Alles auf einen Blick
k-Nächste-Nachbarn-Algorithmus
kNN
Es ordnet einen neuen Punkt anhand seiner k nächsten Nachbarn einer Klasse zu.
Lernen
Es besteht aus dem Abspeichern der Trainingsbeispiele.
Ablauf
Abstände berechnen, k kleinste wählen, Klassen zählen, Mehrheit entscheidet.
Wahl von k
Zu kleines k macht anfällig für Rauschen, zu großes k bezieht weit entfernte Punkte ein.
Normalisierung
Sie kann die Genauigkeit erhöhen; große und kleine Zahlenwerte sollen so gleich stark zählen.
Bewertung
Training zum Trainieren, Validierung zum Vergleichen von Einstellungen, Test zur Prüfung am Ende.
Musteraufgabe · Schritt für Schritt
Neuen Punkt mit k = 3 einordnen (ausgedachtes Beispiel)
- 1Ausgedachte Daten mit zwei Merkmalen. Klasse A: A1 (1, 2), A2 (2, 0). Klasse B: B1 (4, 4), B2 (5, 3), B3 (6, 6). Neuer Punkt N = (3, 3), k = 3.
- 2Abstand N zu B1: √((4 − 3)² + (4 − 3)²) = √2 ≈ 1,41
- 3Abstand N zu B2: √((5 − 3)² + (3 − 3)²) = √4 = 2
- 4Abstand N zu A1: √((1 − 3)² + (2 − 3)²) = √5 ≈ 2,24
- 5Abstand N zu A2: √((2 − 3)² + (0 − 3)²) = √10 ≈ 3,16
- 6Abstand N zu B3: √((6 − 3)² + (6 − 3)²) = √18 ≈ 4,24
- 7Sortiert: B1, B2, A1, A2, B3. Die k = 3 nächsten sind B1, B2 und A1.
- 8Stimmen: 2-mal Klasse B, 1-mal Klasse A. Also gehört N zu Klasse B.
Fehler finden
Prüfe die Schritte bei Q = (0, 0) mit k = 3 (ausgedachtes Beispiel) In einer Zeile steckt ein Fehler. Tippe sie an.
Fehler in Zeile 4Es zählen nur die k = 3 nächsten Nachbarn, nicht alle Punkte. Richtig: R1 und R2 gehören zu X, R3 zu Y. Das ist 2 zu 1, also gehört Q zu Klasse X.
Lückentext
Wähl in jeder Lücke das passende Wort und prüf dann deine Antworten.
Bei kNN besteht das Lernen aus dem der Trainingsbeispiele. Bei zwei Klassen hilft ein k, ein Unentschieden bei der Mehrheitsentscheidung zu verhindern. Die Qualität nach dem Training prüft man an den , die beim Training nicht benutzt wurden.
Karteikasten
Erst selbst überlegen, dann umdrehen.
Übung mit Feedback