

Informatik · Klasse 10–12 · aktualisiert
Informationstheorie: Entropie, Codes und Fehler
Du rechnest mit Informationsgehalt und Entropie, prüfst Präfixcodes und erkennst mit dem Hamming-Abstand, ob ein Code Fehler bemerkt.
0 von 12 Aufgaben gelöst
Kurz gesagt
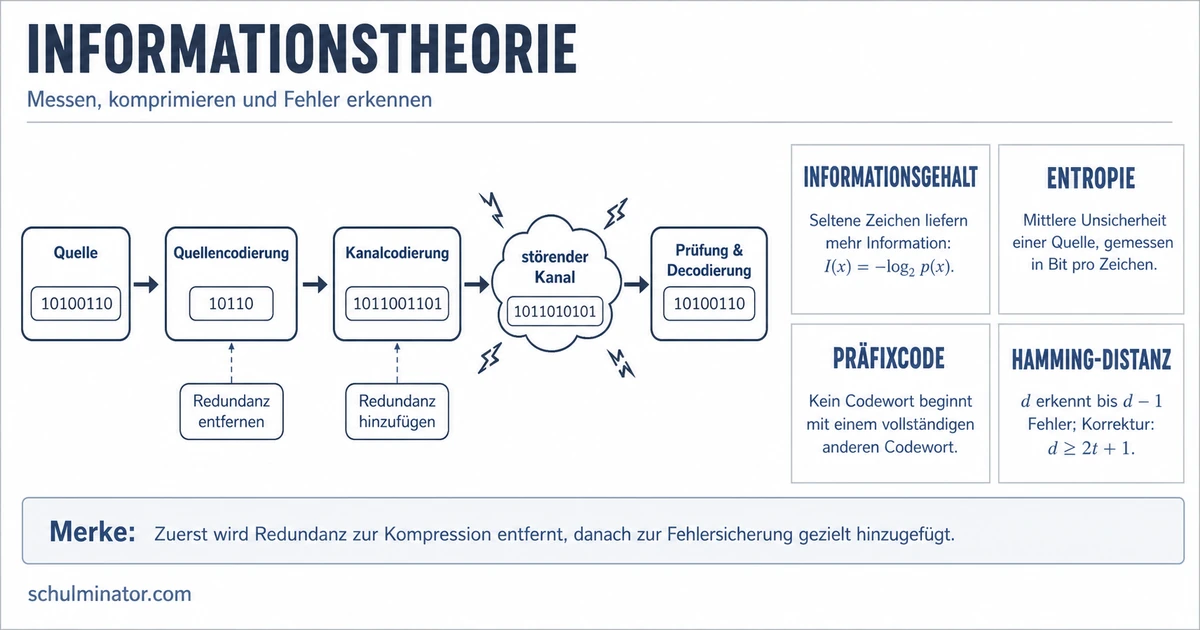
Die Informationstheorie misst Information in Bit: Je seltener ein Zeichen, desto höher sein Informationsgehalt; die Entropie ist der Mittelwert. Quellenkodierung vermindert Redundanz, Kanalkodierung fügt sie zum Fehlerschutz hinzu. Der Hamming-Abstand zeigt, welche Fehler ein Code erkennt.
Jede Nachricht, die dein Handy sendet, besteht aus Bits. Manche Zeichen kommen oft vor, andere selten, und beim Senden können Bits kippen. Die Informationstheorie hilft dir zu rechnen, wie viel Information in einem Zeichen steckt, wie man Daten eindeutig codiert und wie man Übertragungsfehler bemerkt.
Deine Lernziele
Hake ab, was du schon kannst. Löst du alle Aufgaben eines Abschnitts, hakt Mela das Ziel für dich ab.
4 Abschnitte
In der Informationstheorie bedeutet „Information“ etwas anderes als im Alltag. Sie sagt nichts über die Bedeutung. Zwei Nachrichten, von denen eine besonders wichtig ist und die andere nur „Unsinn“ darstellt, können genau die gleiche Menge an Information enthalten. Die Theorie geht auf Claude Shannon zurück; der informationstheoretische Begriff der Entropie existiert seit etwa 1948.
Der Informationsgehalt eines Zeichens hängt von seiner Wahrscheinlichkeit p ab: I = −log₂ p. Je kleiner p ist, desto höher ist der Informationsgehalt. Ein Zeichen, das sehr oft vorkommt, überrascht kaum und trägt wenig Information. Das Ergebnis steht in Bit. Du kannst dir das so vorstellen: Tritt ein Ereignis mit der Wahrscheinlichkeit p ein, wird eines aus 1/p gleich wahrscheinlichen Ereignissen ausgewählt. Um sie zu unterscheiden, braucht man log₂(1/p) Bit. Bei p = 1/8 sind es 8 Ereignisse, und log₂ 8 = 3, weil 2³ = 8. Das ist eine eigene Rechnung zum Üben. Ein Ereignis mit p = 0,5, etwa „Kopf“ beim Münzwurf, hat den Informationsgehalt 1 Shannon (Sh).
Die Entropie H ist der mittlere Informationsgehalt pro Zeichen einer Datenquelle. Du gewichtest dafür den Informationsgehalt jedes Zeichens mit seiner Wahrscheinlichkeit und addierst: H = −(p₁·log₂ p₁ + p₂·log₂ p₂ + …). Diese Formel gilt für eine gedächtnislose Datenquelle, also eine, die sich nicht an frühere Zeichen „erinnert“.
Beim idealen Münzwurf sind „Kopf“ und „Zahl“ gleich wahrscheinlich. Die Ungewissheit ist dann am größten. Bei einer gezinkten Münze mit im Mittel 60 % „Kopf“ und 40 % „Zahl“ liegt die Entropie nur noch bei etwa 0,971. Wirfst du eine ideale Münze zweimal, gibt es vier Möglichkeiten mit je 0,25. Die Entropie ist dann 2 Sh, denn bei mehrfachen idealen Münzwürfen addiert sich die Entropie. Bei n gleich wahrscheinlichen Möglichkeiten gilt H = log₂ n. Ein idealer Achterwürfel hat acht Möglichkeiten: H = log₂ 8 = 3 Sh, so viel wie drei ideale Münzwürfe.
Definition
Entropie
Die Entropie ist ein Maß für den mittleren Informationsgehalt pro Zeichen einer Datenquelle. Man kann sie auch als Maß für beseitigte Unsicherheit verstehen.
Beispiel: Die Zeichenkette ABBCAADA
- 1A kommt 4-mal vor, B 2-mal, C und D je 1-mal: pA = 0,5; pB = 0,25; pC = pD = 0,125
- 2Informationsgehalt: I(A) = 1 bit, I(B) = 2 bit, I(C) = I(D) = 3 bit
- 3H = 0,5 · 1 + 0,25 · 2 + 2 · (0,125 · 3)
- 4H = 0,5 + 0,5 + 0,75 = 1,75 Sh
Merke: Seltene Zeichen tragen viel Information, häufige wenig. Die Entropie ist der Mittelwert über alle Zeichen.
Teste dich
Ein Code ordnet Zeichen Codewörter zu, zum Beispiel Folgen aus 0 und 1. Die Codewörter dürfen unterschiedlich lang sein. Ein Präfixcode (auch präfixfreier Code) erfüllt diese Bedingung: Kein Codewort ist der Beginn eines anderen Codewortes. So prüfst du das: Nimm jedes Codewort und sieh nach, ob ein anderes Codewort mit ihm anfängt. Der Code {0, 10, 11} ist ein Präfixcode. Der Code {0, 01, 10} ist keiner, weil „0“ der Anfang von „01“ ist.
Bei einem Präfixcode lässt sich eine Nachricht eindeutig in ihre Codewörter zerlegen. Das zeigt diese ausgedachte Übung (eine angewandte Übung, die aus der Definition folgt). Der Code lautet A → 0, B → 100, C → 101, D → 11. Kein Codewort beginnt mit einem anderen, es ist also ein Präfixcode. Zerlege 100010111: Du liest von links Bit für Bit. „1“ ist kein Codewort, „10“ auch nicht, „100“ ist B. Weil kein Codewort der Anfang eines anderen ist, kann „100“ nicht der Beginn eines längeren Codewortes sein. Du darfst sofort abschneiden. Danach kommt „0“ = A, dann „101“ = C und zuletzt „11“ = D. Die Nachricht heißt BACD.
Ohne die Präfixeigenschaft klappt das nicht. Der Huffman-Code ist ein Präfixcode. Der Morse-Code ist von Haus aus keiner, weil A (kurz-lang) der Anfang von L (kurz-lang-kurz-kurz) ist. Erst durch Pausen zwischen den Buchstaben wird die Nachricht eindeutig dekodierbar.
Definition
Präfixcode
Ein Präfixcode ist ein Code, in dem kein Codewort der Beginn eines anderen Codewortes ist.
Beispiel: Ein Code ohne Präfixeigenschaft
- 1Code: A → 10, B → 100, C → 101, D → 11
- 2A kollidiert mit B und mit C: „10“ ist der Anfang von „100“ und „101“
- 3CB wird zu 101100, ADB wird zu 1011100
- 4Beide beginnen mit 1011: Wo das erste Codewort endet, steht erst nach einigen Ziffern fest
Merke: Prüfe jedes Codewort gegen alle anderen. Fängt ein anderes Codewort mit ihm an, ist es kein Präfixcode.
Teste dich
Daten haben oft Redundanz. Das sind überflüssige Teile, die keine zusätzliche Information tragen. Bei einer kleinen Entropie enthält ein Text Redundanzen oder statistische Regelmäßigkeiten.
Die Quellenkodierung vermindert diese Redundanz. Sie komprimiert die Nachricht beim Sender, damit weniger Daten gespeichert oder übertragen werden. Verlustfreie Verfahren versuchen, Nachrichten so zu kodieren, dass sie sich ihrer Entropie möglichst gut annähern. Der Huffman-Code ist ein Beispiel.
Die Kanalkodierung macht das Gegenteil. Sie schützt Daten, die über gestörte Kanäle gehen, indem sie Redundanz hinzufügt. Mit dieser Zusatzinformation lassen sich Übertragungsfehler erkennen und oft auch korrigieren. Ein einfaches Beispiel sind Paritätsbits, die man einem Datenwort hinzufügt. Vor Shannons Arbeit gab es nur die einfache Mehrfachübertragung (Wiederholungscode). Die Leitungskodierung ist ein dritter Begriff: Sie passt das Signal an die Anforderungen des Übertragungskanals an.
Beim Mobilfunk GSM sieht man beide Schritte. Die Sprache fällt zuerst als Datenstrom von 64 kbit/s an (Kilobit pro Sekunde). Die GSM-Quellcodierung reduziert ihn auf ca. 13 kbit/s. Danach fügt die Kanalkodierung Redundanz hinzu, weil die Funkübertragung störanfällig ist, und erhöht die Bitrate auf 22,8 kbit/s.
Definition
Kanalkodierung
Die Kanalkodierung schützt digitale Daten bei der Übertragung über gestörte Kanäle gegen Übertragungsfehler, indem sie Redundanz hinzufügt.
| Merkmal | Quellenkodierung | Kanalkodierung |
|---|---|---|
| Aufgabe | Überflüssige Information einer Datenquelle vermindern | Fehler erkennen und korrigieren können |
| Redundanz | wird vermindert | wird hinzugefügt |
| Beispiel GSM | von 64 kbit/s auf ca. 13 kbit/s | auf 22,8 kbit/s erhöht |
Merke: Quellenkodierung spart Redundanz, Kanalkodierung fügt sie zum Schutz vor Fehlern bewusst hinzu.
Teste dich
Der Hamming-Abstand zweier Codewörter gleicher Länge ist die Anzahl der Stellen, an denen sie sich unterscheiden. Beispiele: 00110 und 00100 haben den Abstand 1, „Haus“ und „Baum“ den Abstand 2. Bei binären Codewörtern kannst du auch a XOR b bilden. Das Ergebnis hat an jeder Stelle eine 1, an der sich a und b unterscheiden. Dann zählst du die Einsen.
Der Hamming-Abstand eines Codes ist der kleinste Abstand aller Paare verschiedener Codewörter. Hat ein Code den Abstand h, können alle (h − 1)-Bit-Fehler erkannt werden. Bei h = 1 wird nicht einmal jeder 1-Bit-Fehler erkannt. Bei h = 2 werden alle 1-Bit-Fehler erkannt. Der Grund: Ein 1-Bit-Fehler ändert genau eine Stelle. Bei Abstand 2 entsteht daraus nie ein anderes gültiges Wort, sondern ein ungültiges, und das fällt auf.
Ein Drehschalter mit vier Stellungen sendet 00, 01, 10 oder 11. Je zwei haben den Abstand 1. Wird 00 zu 01 verfälscht, ist das wieder ein gültiges Wort, und der Empfänger merkt nichts. Wählt man stattdessen 001, 010, 100 und 111, ist der Abstand jeweils 2. Kommt dann 011 an, ist klar, dass ein Fehler vorliegt. Sicher korrigieren lässt sich 011 aber nicht, denn es könnte aus 001, 010 oder 111 entstanden sein.
Mit h = 2 bleiben 2-Bit-Fehler möglich. Im Code {000, 101, 110, 011} ist der Abstand 2. Kippt ein Bit, entsteht ein ungültiges Wort. Kippen aber zwei Bits (000 wird 011), ist das Ergebnis wieder gültig und fällt nicht auf.
Definition
Hamming-Abstand
Der Hamming-Abstand zweier Codewörter gleicher Länge ist die Anzahl der Stellen, an denen sie sich unterscheiden. Beim Hamming-Abstand eines Codes nimmst du das Minimum aller Abstände zwischen verschiedenen Wörtern.
Beispiel: Ein Code mit drei Wörtern
- 1Code: x = 00110, y = 00101, z = 01110
- 2x und y unterscheiden sich an 2 Stellen: Abstand 2
- 3x und z unterscheiden sich an 1 Stelle: Abstand 1
- 4y und z unterscheiden sich an 3 Stellen: Abstand 3
- 5Der kleinste Abstand ist 1, also hat der Code den Hamming-Abstand 1
- 6Folge: Nicht jeder 1-Bit-Fehler fällt auf, denn der Wechsel zwischen x und z bleibt unbemerkt
Merke: Der Abstand eines Codes ist der kleinste Abstand aller Paare. Bei Abstand h werden alle (h − 1)-Bit-Fehler erkannt.
Teste dich
Alles auf einen Blick
Informationstheorie
Informationsgehalt
Je seltener ein Zeichen, desto höher sein Informationsgehalt I = −log₂ p
Entropie
mittlerer Informationsgehalt pro Zeichen einer Datenquelle
Präfixcode
kein Codewort ist der Anfang eines anderen, darum ist die Zerlegung eindeutig
Quelle und Kanal
Quellenkodierung vermindert Redundanz, Kanalkodierung fügt sie zum Fehlerschutz hinzu
Hamming-Abstand
Zahl der unterschiedlichen Stellen; beim Code das Minimum aller Abstände
Fehlererkennung
Bei Abstand h werden alle (h − 1)-Bit-Fehler erkannt
Musteraufgabe · Schritt für Schritt
Erkennt dieser Code alle 1-Bit-Fehler? (ausgedachtes Beispiel)
- 1Code: 0000, 0111, 1011, 1100
- 2Abstände: 0000 und 0111 → 3 · 0000 und 1011 → 3 · 0000 und 1100 → 2
- 3Abstände: 0111 und 1011 → 2 · 0111 und 1100 → 3 · 1011 und 1100 → 3
- 4Kleinster Abstand: 2, also hat der Code den Hamming-Abstand 2
- 5Bei h = 2 werden alle (h − 1) = 1-Bit-Fehler erkannt
- 6Probe: Aus 0000 wird durch einen Fehler zum Beispiel 0100, und das ist kein Codewort
Fehler finden
Prüfe die Aussagen zum Code mit vier Wörtern (ausgedachtes Beispiel) In einer Zeile steckt ein Fehler. Tippe sie an.
Fehler in Zeile 4Der Abstand eines Codes ist das Minimum aller Abstände, nicht das Maximum. Richtig: Der kleinste Abstand ist 2, also hat der Code den Hamming-Abstand 2 und erkennt alle 1-Bit-Fehler.
Lückentext
Wähl in jeder Lücke das passende Wort und prüf dann deine Antworten.
Ein Ereignis mit der Wahrscheinlichkeit 0,5 hat den Informationsgehalt . Im Code {0, 01, 10} ist „0“ ein Präfix von . Ein Code mit Hamming-Abstand 2 erkennt alle .
Karteikasten
Erst selbst überlegen, dann umdrehen.
Übung mit Feedback