

Informatik · Klasse 10–12 · aktualisiert
Datenkompression: RLE, Huffman und LZW erklärt
Du lernst, wie Daten kleiner werden: verlustfrei oder verlustbehaftet, mit RLE, Huffman und LZW – und warum nicht jede Datei schrumpfen kann.
0 von 15 Aufgaben gelöst
Kurz gesagt
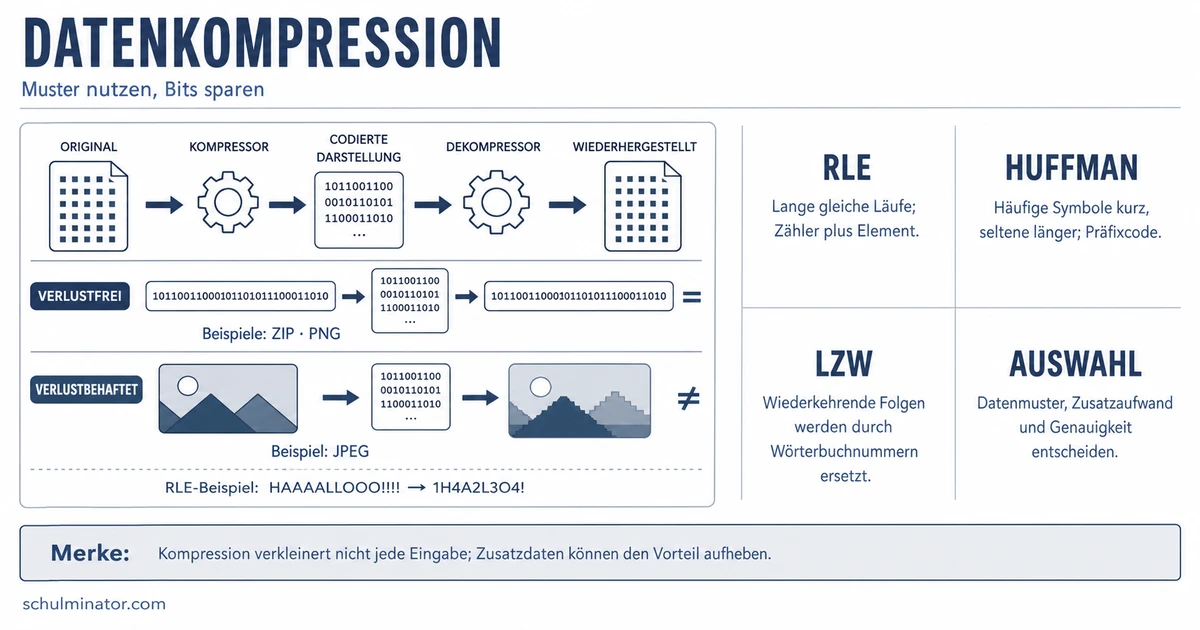
Datenkompression verringert die Menge digitaler Daten, sodass der Speicherbedarf sinkt und die Übertragung schneller geht. Bei verlustfreier Kompression kommt das Original exakt zurück, bei verlustbehafteter geht ein Teil der Information verloren. Nicht jede Datei lässt sich verlustfrei verkürzen.
Ein Foto vom Handy, ein Song, eine App: Am Ende ist alles nur Daten. Damit sie weniger Speicher brauchen und schneller ankommen, werden sie komprimiert. Du lernst hier einfache Verfahren kennen und siehst, wo ihre Grenzen liegen.
Deine Lernziele
Hake ab, was du schon kannst. Löst du alle Aufgaben eines Abschnitts, hakt Mela das Ziel für dich ab.
5 Abschnitte
Bei der Datenkompression wird die Menge digitaler Daten kleiner gemacht. Dadurch sinkt der Speicherbedarf, und die Daten kommen schneller an. Das Gegenstück heißt Dekompression: Die Daten werden wieder entpackt.
Bei der verlustfreien Kompression kannst du aus den komprimierten Daten wieder exakt die Originaldaten gewinnen. Das ist zum Beispiel bei ausführbaren Programmdateien notwendig. Solche Verfahren nutzen Redundanz. Das sind überflüssige, wiederholte Informationen, die man kürzer aufschreiben kann.
Bei der verlustbehafteten Kompression geht ein Teil der Information verloren. Die Originaldaten lassen sich meist nicht mehr exakt zurückgewinnen. Die Verfahren versuchen, möglichst nur „unwichtige“ Informationen wegzulassen. Man nutzt sie häufig bei Bildern, Video und Ton. Ein bekanntes Beispiel ist MP3: Es entfernt Frequenzmuster (Tonanteile), die der Mensch schlecht oder gar nicht hört.
Bei Live-Übertragungen sind Qualitätseinbußen vertretbar, wenn dafür die mögliche Übertragungsrate eingehalten wird. Bei Telefongesprächen wird der Gesprächspartner oft auch bei schlechter Tonqualität noch verstanden.
Definition
Verlustfreie Kompression
Aus den komprimierten Daten lassen sich wieder exakt die Originaldaten gewinnen. Es geht keine Information verloren.
| Merkmal | Verlustfrei | Verlustbehaftet |
|---|---|---|
| Original zurückholen | Exakt möglich | Meist nicht mehr exakt |
| Typisches Beispiel | Programmdateien | MP3 bei Ton |
| Immer möglich? | Nur bei Redundanz | Stets möglich |
Beispiel: Ein Satz wird verlustbehaftet gekürzt
- 1Original: „Das Haus ist groß“
- 2Gekürzt: „Das Haus ist gr“
- 3Frage „Welche Eigenschaft hat das Haus?“: Man kann nicht mehr unterscheiden, ob es „grau“, „grün“ oder „groß“ ist.
- 4Frage „Wurde etwas über ein Haus gesagt?“: Das lässt sich weiterhin eindeutig mit Ja beantworten.
Teste dich
Bei der Lauflängencodierung (englisch run-length encoding, kurz RLE) werden gleiche Zeichen, die hintereinander stehen, nur einmal gespeichert – mit der Anzahl ihrer Wiederholungen. RLE ist verlustfrei und eignet sich für längere Wiederholungen von Symbolen.
Aus einer Folge aus fünf A wird zum Beispiel „A5“. Bei Texten brauchst du also beides: das Zeichen und die Anzahl.
Wie gut RLE wirkt, hängt von der Länge der Wiederholungen ab. Für 10 Wiederholungen brauchst du zwei Dezimalstellen, für 100 drei, für 1000 vier. Die Zahl wächst also viel langsamer als die Folge. Bei langen Wiederholungen spart man deshalb erheblich Speicherplatz. Umgekehrt ist die Einsparung umso geringer, je kürzer die Wiederholungen sind. Im ungünstigsten Fall, ganz ohne Wiederholungen, ist die „komprimierte“ Nachricht größer als das Original: Aus ABCD würde A1B1C1D1.
Gute Ergebnisse erzielt RLE zum Beispiel bei Schwarz-Weiß-Seiten, die per Fax gesendet werden. Dort wechseln sich lange weiße Bereiche mit kürzeren schwarzen ab. Bei Bitfolgen gibt es nur Nullen und Einsen. Sender und Empfänger vereinbaren, mit welchem Bit man beginnt. Danach werden abwechselnd die Längen der Null-Folgen und der Eins-Folgen übertragen.
Beispiel: Eine Zeichenfolge mit RLE codieren (ausgedachtes Beispiel)
- 1Folge: XXXXXXYYYZ (10 Zeichen)
- 2X steht 6-mal hintereinander → X6
- 3Y steht 3-mal hintereinander → Y3
- 4Z steht 1-mal → Z1
- 5Ergebnis: X6Y3Z1 (6 Zeichen), also kürzer als das Original
Merke: Je länger die Wiederholungen sind, desto größer ist die Einsparung. Ohne Wiederholungen wird das Ergebnis im ungünstigsten Fall größer als das Original.
Teste dich
Die Huffman-Kodierung wurde 1952 von David A. Huffman entwickelt. Sie gibt jedem Zeichen ein Codewort aus Bits. Die Codewörter haben unterschiedliche Längen. Häufiger vorkommende Zeichen bekommen weniger Bits als seltener vorkommende. Üblicherweise wird die Huffman-Kodierung für verlustfreie Kompression benutzt.
Damit man die Bits ohne Trennzeichen wieder entschlüsseln kann, muss der Code präfixfrei sein: Kein Codewort darf der Beginn eines anderen sein. So prüfst du das: Nimm jedes Codewort und schau, ob ein anderes Codewort mit genau diesen Bits anfängt. Wenn ja, ist der Code nicht präfixfrei. Bei den Codewörtern 1 und 10 ist zum Beispiel 1 der Beginn von 10. Ein solcher Code braucht Trennzeichen.
Die mittlere Codewortlänge sagt, wie viele Bits ein Zeichen im Durchschnitt braucht. Du multiplizierst die Länge jedes Codeworts mit der Häufigkeit seines Zeichens und addierst alles. Häufigkeiten schreibst du als Anteile, zum Beispiel 0,4 für 40 Prozent.
Der Huffman-Baum liefert garantiert eine optimale und präfixfreie Kodierung. Es gibt dann kein Verfahren, das jedes Zeichen einzeln codiert und einen kürzeren Code liefert, wenn die Wahrscheinlichkeiten der Zeichen bekannt sind. Zum Entpacken braucht man beim klassischen Verfahren außerdem das Codebuch, das beim Komprimieren erstellt wurde.
Definition
Präfixfrei
Ein Code ist präfixfrei, wenn kein Codewort der Beginn eines anderen Codeworts ist. Dann braucht man beim Entschlüsseln keine Trennzeichen.
Beispiel: Einen Code für vier Zeichen prüfen
- 1Code: a → 1, b → 01, c → 001, d → 000
- 2Häufigkeiten: a 0,4 · b 0,3 · c 0,2 · d 0,1
- 3Präfixfrei? Nur a beginnt mit 1. 01 ist nicht der Anfang von 001 oder 000. 001 und 000 sind gleich lang und verschieden. Ja, der Code ist präfixfrei.
- 4Mittlere Länge: 0,4 · 1 + 0,3 · 2 + 0,2 · 3 + 0,1 · 3 = 0,4 + 0,6 + 0,6 + 0,3 = 1,9 Bit
- 5Zum Vergleich: Ein fester Code für 4 Zeichen braucht 2 Bit pro Zeichen.
Merke: Mittlere Codewortlänge: Länge jedes Codeworts mal Häufigkeit seines Zeichens, dann alles addieren.
Teste dich
LZW (nach Lempel, Ziv und Welch) ist ein verlustfreies Verfahren. Es arbeitet mit einem Wörterbuch. Das ist eine Tabelle, in der Zeichenketten eine Nummer bekommen. Das Wörterbuch wächst während des Komprimierens und passt sich so dem Inhalt an.
Am Anfang sind die Einträge 0 bis 255 schon mit den einzelnen Bytes gefüllt. Neue Einträge beginnen deshalb bei der Nummer 256.
So geht der Algorithmus vor: Erst suchst du am Anfang der restlichen Eingabe das längste Muster, das schon im Wörterbuch steht, und gibst seine Nummer aus. Dann hängst du das nächste Zeichen der Eingabe an dieses Muster an und speicherst das Ergebnis als nächsten Eintrag. So geht es immer weiter.
Das Wörterbuch muss nicht mitgeschickt werden. Der Dekompressor, also das Programm zum Entpacken, baut es aus den komprimierten Daten selbst wieder auf. Im Beispiel unten hat die Eingabe 22 Zeichen zu je 8 Bit, das sind 176 Bit. Am Ende stehen dort 16 Zeichen zu je 12 Bit, das sind 192 Bit. Bei dieser kurzen Eingabe ist das Ergebnis also nicht kürzer.
Definition
LZW-Wörterbuch
Eine Tabelle, in der Zeichenketten eine Nummer haben. Die Nummern 0 bis 255 gehören den einzelnen Bytes. Neue Einträge entstehen beim Komprimieren und beginnen bei 256.
Beispiel: Die ersten vier Schritte bei LZWLZ78LZ77LZCLZMWLZAP
- 1Schritt 1: L ist bekannt → Ausgabe L, neuer Eintrag LZ (wird <256>)
- 2Schritt 2: Z ist bekannt → Ausgabe Z, neuer Eintrag ZW (wird <257>)
- 3Schritt 3: W ist bekannt → Ausgabe W, neuer Eintrag WL (wird <258>)
- 4Schritt 4: LZ steht schon im Wörterbuch (<256>) → Ausgabe <256>, neuer Eintrag LZ7 (wird <259>)
- 5Die ganze Ausgabe: L Z W <256> 7 8 <259> 7 <256> C <256> M <258> Z A P (16 Zeichen)
Teste dich
Verlustfrei lassen sich nur Daten komprimieren, die in irgendeiner Form redundant sind. Hat eine Datei keinerlei erkennbare Struktur, gibt es nichts, was man kürzer aufschreiben könnte.
Dazu kommt das Taubenschlagprinzip: Gibt es weniger Nistplätze als Tauben, müssen sich zwei oder mehr Tauben einen Nistplatz teilen. Auf n Bit passen 2ⁿ mögliche Informationen. Mit einem Bit weniger gibt es nur halb so viele. Auf 16 Bit passen 2¹⁶ = 65536 Informationen, auf 15 Bit nur 2¹⁵ = 32768.
Angenommen, jede Datei ließe sich um ein Bit verkleinern. Dann müssten sich zwei verschiedene Originale dasselbe kürzere Muster teilen. Bei verlustfreier Kompression muss aber jede komprimierte Datei zu genau einem Original gehören. Das geht nicht.
Ein zweiter Gedanke: Gäbe es ein Verfahren, das jede Datei um mindestens ein Bit kürzt, könnte man es immer wieder auf das Ergebnis anwenden. Jede Information ließe sich dann auf 0 Bit reduzieren. Das kann nicht stimmen.
Also lassen sich zwar viele, aber nicht alle Daten komprimieren. Rein zufällige Daten sind höchstwahrscheinlich unkomprimierbar. Verlustbehaftete Kompression ist dagegen stets möglich, denn man kann immer mehr „Unwichtiges“ weglassen.
| Speicherplatz | Rechnung | Mögliche Informationen |
|---|---|---|
| 16 Bit | 2¹⁶ | 65536 |
| 15 Bit | 2¹⁵ | 32768 |
Merke: Ein Bit weniger Platz heißt nur halb so viele Möglichkeiten. Deshalb kann kein verlustfreies Verfahren jede Datei verkürzen.
Teste dich
Alles auf einen Blick
Datenkompression
Verlustfrei
Aus den komprimierten Daten entstehen wieder exakt die Originaldaten.
Verlustbehaftet
Ein Teil der Information geht verloren, zum Beispiel bei MP3.
RLE
Gleiche Zeichen hintereinander werden mit ihrer Anzahl gespeichert. Bei kurzen Wiederholungen spart man wenig.
Huffman
Präfixfrei heißt, kein Codewort ist der Beginn eines anderen. Die mittlere Länge ist die Summe aus Länge mal Häufigkeit.
LZW
Neue Wörterbucheinträge ab 256 entstehen aus gefundenem Eintrag plus nächstem Zeichen.
Grenze
Nicht jede Datei lässt sich verlustfrei verkürzen.
Musteraufgabe · Schritt für Schritt
ABABABA mit LZW komprimieren (ausgedachtes Beispiel)
- 1Aufgabe: Komprimiere ABABABA mit LZW. Die Einträge 0 bis 255 sind belegt, der erste neue Eintrag bekommt die Nummer 256.
- 2Rest ABABABA: Das längste bekannte Muster ist A. Ausgabe A. Neuer Eintrag: AB (wird <256>)
- 3Rest BABABA: Das längste bekannte Muster ist B. Ausgabe B. Neuer Eintrag: BA (wird <257>)
- 4Rest ABABA: AB ist bekannt (<256>), ABA noch nicht. Ausgabe <256>. Neuer Eintrag: ABA (wird <258>)
- 5Rest ABA: ABA ist bekannt (<258>). Ausgabe <258>. Kein Zeichen folgt mehr, also kein neuer Eintrag.
- 6Ergebnis: A B <256> <258>
- 7Probe: A + B + AB + ABA ergibt ABABABA
Fehler finden
Prüfe die Aussagen zu einem Code für drei Zeichen (ausgedachtes Beispiel) In einer Zeile steckt ein Fehler. Tippe sie an.
Fehler in Zeile 4Hier werden die Häufigkeiten vergessen und die Längen nur gemittelt. Richtig: 0,5 · 1 + 0,3 · 2 + 0,2 · 2 = 0,5 + 0,6 + 0,4 = 1,5 Bit.
Lückentext
Wähl in jeder Lücke das passende Wort und prüf dann deine Antworten.
Bei RLE braucht man für 1000 Wiederholungen nur vier Dezimalstellen. Die Einsparung ist daher umso größer, je die Wiederholungen sind. In einem präfixfreien Code braucht man keine Trennzeichen, weil kein Codewort der eines anderen Codeworts ist. Bei LZW sind die Einträge 0 bis 255 schon belegt, neue Einträge bekommen deshalb ab eine Nummer.
Karteikasten
Erst selbst überlegen, dann umdrehen.
Übung mit Feedback