

Informatik · Klasse 10–12 · aktualisiert
Huffman-Codierung einfach erklärt
Du lernst, warum Huffman-Codes präfixfrei sind, baust einen Huffman-Baum, codierst und decodierst und beurteilst, wie gut die Kompression ist.
0 von 13 Aufgaben gelöst
Kurz gesagt
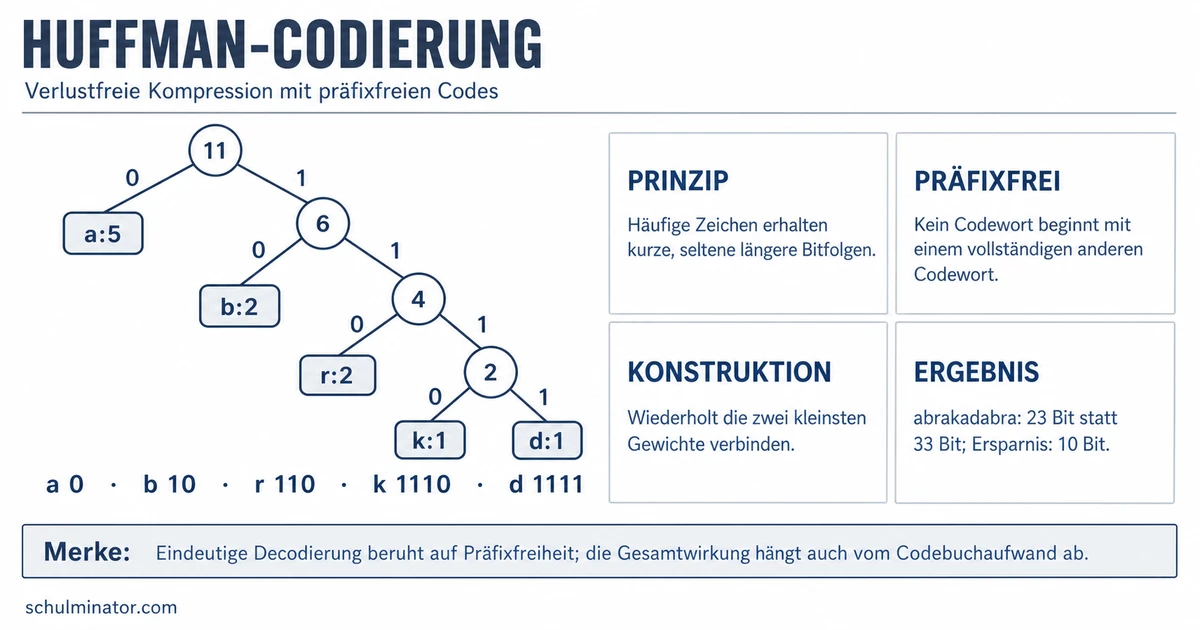
Die Huffman-Codierung gibt häufigen Zeichen in der Regel kürzere Codewörter als seltenen. Kein Codewort ist der Beginn eines anderen, darum braucht man keine Trennzeichen. Kein Verfahren, das jedes Zeichen einzeln codiert, ist bei bekannten Häufigkeiten besser.
Ein Text mit vielen gleichen Buchstaben muss nicht jeden Buchstaben gleich lang speichern. Ein Zeichen, das oft vorkommt, bekommt wenige Bits, ein seltenes mehr. Genau das macht die Huffman-Codierung. Hier lernst du, wie das funktioniert und wo es an Grenzen stößt.
Deine Lernziele
Hake ab, was du schon kannst. Löst du alle Aufgaben eines Abschnitts, hakt Mela das Ziel für dich ab.
4 Abschnitte
Bei der Huffman-Codierung bekommen die Zeichen Codewörter mit unterschiedlicher Länge. Ein Codewort ist eine kurze Folge aus Bits, zum Beispiel 01. Im fertigen Bitstrom stehen die Codewörter ohne Lücken hintereinander. Du musst also selbst erkennen, wo ein Codewort endet.
Um einen Code eindeutig decodieren zu können, muss er präfixfrei sein: Kein Codewort darf der Beginn eines anderen Codeworts sein. Der Huffman-Code ist ein solcher Präfixcode. Beim Morsecode braucht man dagegen Trennzeichen. Bei der Huffman-Codierung ist keine Trennung nötig, weil die Codierung präfixfrei ist.
Die Codewörter lesen wir an einem Baum ab. Die Wurzel ist der oberste Knoten, ein Blatt ist ein Knoten ganz unten ohne Kinder. Im Huffman-Baum stehen die Zeichen nur in den Blättern. Der Pfad von der Wurzel zum Blatt bestimmt das Codewort. So kann kein Codewort der Anfang eines anderen sein.
Beim Decodieren gehst du mit jedem Bit einen Schritt im Baum, bis du ein Blatt erreichst. Dieses Blatt ist das Zeichen. Dann beginnst du wieder an der Wurzel. Ein präfixfreies Beispiel ist das Codebuch a→1, b→01, c→001, d→000.
Definition
Präfixfrei
Ein Code ist präfixfrei, wenn kein Codewort der Beginn eines anderen Codeworts ist.
Beispiel: Ein ausgedachter Code, der nicht präfixfrei ist
- 1Erfundenes Codebuch (kein echter Huffman-Code): a→0, b→01, c→1
- 2Bitfolge: 01
- 3Lesart 1: 01 ist das Codewort von b
- 4Lesart 2: 0 ist a und 1 ist c, also ac
- 5Das Codewort 0 ist der Beginn von 01. Der Code ist nicht präfixfrei, deshalb ist die Bitfolge mehrdeutig.
Merke: Präfixfrei heißt: Kein Codewort ist der Beginn eines anderen. Dann brauchst du keine Trennzeichen zwischen den Codewörtern.
Teste dich
Zuerst zählst du, wie oft jedes Zeichen vorkommt. Teilst du durch die Anzahl aller Zeichen, erhältst du die relative Häufigkeit. Jedes Zeichen bekommt dann einen eigenen Knoten, in den du seine Häufigkeit schreibst.
Dann wiederholst du: Wähle die zwei Bäume, die in ihrer Wurzel die geringsten Häufigkeiten haben, und fasse sie zu einem neuen Baum zusammen. In dessen Wurzel schreibst du die Summe der beiden Häufigkeiten. Das machst du, bis nur noch ein Baum übrig ist. Mit jedem Schritt wird aus m Symbolen ein Problem mit m−1 Symbolen. Bei 5 Symbolen brauchst du deshalb 4 Schritte, bei 7 Symbolen 6 Schritte. Ein zweites Beispiel mit 7 Symbolen hat A mit 0,4 und sechs Symbole mit je 0,1. Gibt es mehrere mögliche Wahlen, ist die Wahl im Allgemeinen nicht eindeutig.
Der Baum entsteht von den Blättern zur Wurzel (englisch bottom-up). Für die Codewörter schreibst du auf die beiden Kanten unter einem Knoten 0 und 1. Eine Kante ist die Verbindungslinie zwischen zwei Knoten. Das Codewort eines Zeichens liest du ab, indem du an der Wurzel beginnst und die Zeichen auf den Kanten bis zum Blatt hintereinander schreibst.
Beispiel: Baum für fünf Symbole (0,4 und viermal 0,15)
- 1Start: A 0,4 · B 0,15 · C 0,15 · D 0,15 · E 0,15
- 2Schritt 1: D und E (je 0,15) werden zu einem Baum mit 0,3. D bekommt 0, E bekommt 1.
- 3Schritt 2: B und C (je 0,15) werden zu einem Baum mit 0,3.
- 4Schritt 3: Die Bäume BC (0,3) und DE (0,3) werden zu einem Baum mit 0,6.
- 5Schritt 4: A (0,4) und der Baum BCDE (0,6) werden zum ganzen Baum mit 1,0. A bekommt 0, der Teilbaum 1.
- 6Codebuch: A→0, B→100, C→101, D→110, E→111
Merke: Du fasst immer die Bäume mit den kleinsten Häufigkeiten zusammen und schreibst die Summe in die neue Wurzel. So wächst der Baum von den Blättern zur Wurzel.
Teste dich
Ein Codebuch ist eine Liste, die jedem Zeichen sein Codewort zuordnet. Beim Codieren machst du für jedes Zeichen drei Dinge: Du liest das Zeichen ein, suchst sein Codewort im Codebuch und gibst das Codewort aus. Die Codewörter hängst du ohne Lücken aneinander.
Beim Decodieren gehst du umgekehrt vor. Beim klassischen Verfahren brauchst du dazu das Codebuch, das der Codierer erstellt hat. Der Huffman-Baum wird wieder aufgebaut. Mit jedem Bit gehst du von der Wurzel aus einen Schritt, bis du ein Blatt erreichst. Das Blatt ist das Zeichen. Danach beginnst du für das nächste Zeichen wieder an der Wurzel.
Bei der adaptiven Huffman-Codierung wird der Baum laufend aktualisiert. Der Decodierer kann das nachvollziehen. Deshalb muss dort kein Codebuch übertragen werden.
Definition
Codebuch
Das Codebuch ist die Liste, die jedem Zeichen sein Codewort zuordnet, zum Beispiel t→0110.
Beispiel: Das Wort „this“ im Beispielsatz codieren
- 1Codebuch-Auszug zum Satz „this is an example of a huffman tree“: t→0110, h→1010, i→1000, s→1011, Leerzeichen→111
- 2Wort „this“: t → 0110, h → 1010, i → 1000, s → 1011
- 3Zusammen: 0110 1010 1000 1011 (die Lücken dienen nur der Lesbarkeit)
- 4Das Leerzeichen danach wird zu 111.
Teste dich
Die Bitlänge einer codierten Nachricht erhältst du, indem du für jedes Zeichen Häufigkeit mal Codewortlänge rechnest und alles addierst. Teilst du durch die Anzahl der Zeichen, bekommst du die mittlere Codewortlänge in Bit pro Zeichen. Beim Satz „this is an example of a huffman tree“ sind das 135 Bit für 36 Zeichen, also 135 : 36 = 3,75 Bit pro Zeichen.
Zum Vergleich: Für 16 verschiedene Zeichen brauchen gleich lange Codewörter 4 Bit pro Zeichen, denn 2 hoch 4 ist 16. Das sind 36 · 4 = 144 Bit. Mit Huffman sind es 135 Bit.
Grenzen: Die Entropie ist ein Maß für den mittleren Informationsgehalt pro Zeichen. Je seltener ein Zeichen vorkommt, desto höher ist seine Information. Die mittlere Länge eines Huffman-Codes liegt zwischen der Entropie H und H + 1. Sie ist genau dann gleich H, wenn alle Wahrscheinlichkeiten Zweierpotenzen sind, also 1/2, 1/4, 1/8 und so weiter. Sonst bleibt eine Rest-Redundanz, weil der Informationsgehalt eines Zeichens keine ganze Zahl ist. Im Beispiel aababcabcd sind es 1,9 Bit statt der Entropie von etwa 1,846 Bit. Fasst man n Zeichen zu einem großen Symbol zusammen, geht die mittlere Länge mit wachsendem n gegen die Entropie.
Der Huffman-Baum liefert garantiert eine optimale präfixfreie Codierung: Kein Verfahren, das jedes Symbol einzeln codiert, erzeugt einen kürzeren Code, wenn die Wahrscheinlichkeiten der Symbole bekannt sind. Huffman wird üblicherweise für verlustfreie Kompression benutzt, bei der keine Information verloren geht. Die adaptive Variante ist erheblich anfälliger für Übertragungsfehler, weil ein einziger Fehler ab der Fehlerstelle zu komplett falscher Decodierung führt.
Definition
Mittlere Codewortlänge
Die mittlere Codewortlänge ist die Summe aus Häufigkeit mal Codewortlänge über alle Zeichen, in Bit pro Zeichen.
Beispiel: Mittlere Länge beim Text aababcabcd
- 1Häufigkeiten: a 0,4 · b 0,3 · c 0,2 · d 0,1. Codebuch: a→1, b→01, c→001, d→000
- 2Mittlere Länge: 0,4·1 + 0,3·2 + 0,2·3 + 0,1·3 = 0,4 + 0,6 + 0,6 + 0,3 = 1,9 Bit pro Zeichen
- 3Gleich lange Codewörter für 4 Symbole brauchen 2 Bit pro Zeichen.
- 4Die Entropie beträgt etwa 1,846 Bit je Symbol. Die mittlere Länge 1,9 liegt knapp darüber.
Merke: Die mittlere Länge liegt zwischen H und H + 1. Genau bei H liegt sie nur, wenn alle Wahrscheinlichkeiten Zweierpotenzen sind.
Teste dich
Alles auf einen Blick
Huffman-Codierung
Präfixfrei
Kein Codewort ist der Beginn eines anderen, darum braucht man keine Trennzeichen.
Baum bauen
Die Bäume mit den geringsten Häufigkeiten zusammenfassen und die Summe notieren, bis ein Baum bleibt.
Codewort ablesen
Von der Wurzel bis zum Blatt die Zeichen auf den Kanten hintereinander schreiben.
Decodieren
Bit für Bit von der Wurzel zum Blatt gehen, dann wieder an der Wurzel beginnen.
Bitlänge
Häufigkeit mal Codewortlänge, über alle Zeichen addiert.
Grenze
Die mittlere Länge liegt zwischen der Entropie H und H + 1.
Musteraufgabe · Schritt für Schritt
Wörter mit dem Codebuch A bis E codieren und decodieren
- 1Codebuch: A→0, B→100, C→101, D→110, E→111
- 2Aufgabe a: Codiere das Wort BAD.
- 3B → 100, A → 0, D → 110
- 4Zusammen: 1000110 (7 Bit)
- 5Aufgabe b: Decodiere 1010111.
- 6Von der Wurzel aus: 101 führt zu einem Blatt (C), dann 0 (A), dann 111 (E)
- 7Ergebnis: CAE
- 8Probe: C→101, A→0, E→111 ergibt wieder 1010111
Fehler finden
Prüfe die Aussagen zum Baum mit sieben Symbolen In einer Zeile steckt ein Fehler. Tippe sie an.
Fehler in Zeile 3Das ist die falsche Auswahl: Du fasst die Bäume mit den geringsten Häufigkeiten zusammen. Richtig: Zuerst kommen zwei Symbole mit je 0,1 zusammen, ihre neue Wurzel hat die Summe 0,2.
Lückentext
Wähl in jeder Lücke das passende Wort und prüf dann deine Antworten.
Ein Code ist präfixfrei, wenn kein Codewort der eines anderen Codeworts ist. Beim Decodieren startest du für jedes neue Zeichen wieder . Häufige Zeichen bekommen in der Regel Codewörter als seltene.
Karteikasten
Erst selbst überlegen, dann umdrehen.
Übung mit Feedback