

Informatik · Klasse 10–12 · aktualisiert
LZW-Kompression: Codieren, decodieren und Platzbedarf prüfen
Du lernst, wie LZW sein Wörterbuch aufbaut, Zeichenfolgen codiert und decodiert, den Sonderfall löst und prüfst, ob Speicher gespart wird.
0 von 11 Aufgaben gelöst
Kurz gesagt
LZW ist ein verlustfreies Verfahren, das Daten mit einem dynamischen Wörterbuch kürzer aufschreibt. Der Kompressor ersetzt bekannte Muster durch Codes ab 256, der Decoder baut dasselbe Wörterbuch aus den Codes nach. Ob das Platz spart, musst du in Bit nachrechnen.
Beim Verschicken von Bildern und Texten soll die Datenmenge klein bleiben. LZW schafft das, ohne ein fertiges Wörterbuch mitzuschicken. Wie das Wörterbuch beim Lesen wächst und warum es trotzdem nicht immer Platz spart, findest du hier heraus.
Deine Lernziele
Hake ab, was du schon kannst. Löst du alle Aufgaben eines Abschnitts, hakt Mela das Ziel für dich ab.
4 Abschnitte
LZW ist ein verlustfreies Komprimierungsverfahren. Aus den komprimierten Daten bekommst du also die ursprünglichen Daten wieder. Das Verfahren arbeitet mit einem dynamischen Wörterbuch. Darin sammeln sich häufig vorkommende Zeichenketten. Sie werden dann nur noch unter einer Abkürzung angesprochen. Diese Abkürzung ist eine Nummer, der Index.
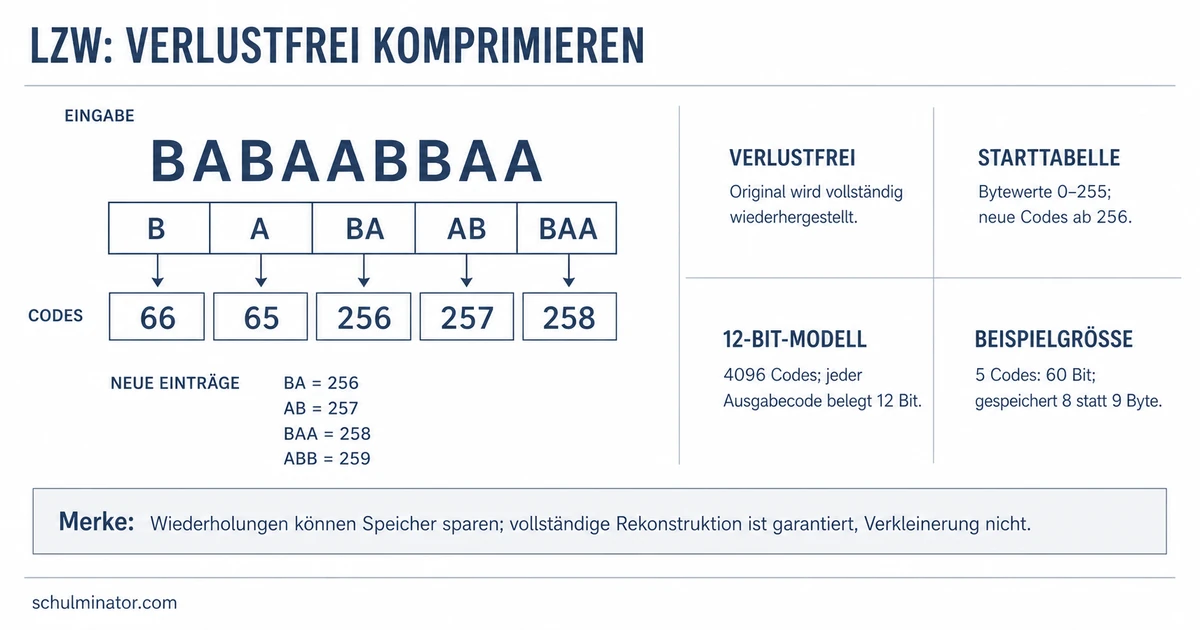
Am Anfang stehen im Wörterbuch nur einzelne Bytes (ein Byte ist hier ein Zeichen aus 8 Bit). Die Einträge mit dem Index 0 bis 255 sind damit gefüllt. Das Wörterbuch beginnt also nicht leer. Neue Einträge beginnen deshalb mit dem Index 256. Ein neuer Eintrag entsteht so: Der Kompressor sucht an der Eingabe das längste Muster, das schon im Wörterbuch steht, und gibt dessen Wert aus. Dann speichert er den gefundenen Eintrag plus das nächste Zeichen als neuen Eintrag.
Das Wörterbuch wird erst zur Laufzeit erzeugt, also während das Verfahren arbeitet. Deshalb ist es unabhängig vom Format der Daten. Der Kompressor führt es intern mit, speichert es aber nicht. Der Decoder (das Programm, das wieder entpackt) baut es aus den Codes selbst auf. Es muss also nicht übertragen werden.
Definition
Dynamisches Wörterbuch
Eine Tabelle aus Index und Zeichenkette, die sich während des Lesens der Daten füllt. Sie passt sich dem jeweiligen Inhalt an.
Beispiel: Erste Schritte mit LZWLZ78LZ77LZCLZMWLZAP
- 1L gelesen: Ausgabe L, neuer Eintrag LZ = 256
- 2Z gelesen: Ausgabe Z, neuer Eintrag ZW = 257
- 3W gelesen: Ausgabe W, neuer Eintrag WL = 258
- 4Danach wird LZ als Ganzes gefunden und als 256 ausgegeben
- 5Neuer Eintrag dabei: LZ7 = 259
Teste dich
Hinweis: In den Beispielen schreiben wir einzelne Zeichen als sie selbst. Codes ab 256 schreiben wir als Zahl.
Beim Codieren liest du Zeichen für Zeichen und hältst ein Muster fest. Du schaust auf das nächste Zeichen. Steht Muster plus nächstes Zeichen schon im Wörterbuch, wird das Muster verlängert. Sonst trägst du Muster plus Zeichen als neuen Eintrag ein, gibst das Muster aus und beginnst mit dem Zeichen neu. Am Ende wird das übrige Muster noch ausgegeben.
Beim Decodieren gibst du den ersten Code unverändert aus. Bei jedem weiteren Code trägst du das vorherige Muster plus das erste Zeichen des aktuellen Musters als neuen Eintrag ein. Danach gibst du das aktuelle Muster aus. Das klappt, weil der Kompressor immer nur das alte Muster und nicht das neue Muster mit dem nächsten Zeichen ausgegeben hat. So entsteht beim Decodieren genau das gleiche Wörterbuch.
Beispiel: TOTO codieren und decodieren (erfundenes Beispiel)
- 1Am Anfang kennt das Wörterbuch alle einzelnen Zeichen
- 2T, nächstes O: TO fehlt. Ausgabe T, neuer Eintrag TO = 256
- 3O, nächstes T: OT fehlt. Ausgabe O, neuer Eintrag OT = 257
- 4T, nächstes O: TO ist da, das Muster wird TO. Die Eingabe ist zu Ende: Ausgabe 256
- 5Codefolge: T O 256
- 6Decodieren: T ausgeben. O ausgeben, Eintrag TO = 256
- 7Code 256 ist TO: Eintrag OT = 257 (O plus T), Ausgabe TO
- 8Ergebnis: TOTO
Merke: Codieren: Muster plus nächstes Zeichen eintragen, Muster ausgeben. Decodieren: vorheriges Muster plus erstes Zeichen des aktuellen Musters eintragen, aktuelles Muster ausgeben.
Teste dich
Beim Decodieren brauchst du das erste Zeichen des aktuellen Musters. Problematisch wird es, wenn das auszugebende Muster noch nicht in der Tabelle eingetragen ist. Der Code gehört dann zu dem Eintrag, den der Decoder gerade erst anlegen will. Dann kann man auch nicht in der Tabelle nach dem ersten Zeichen dieses Musters suchen.
Das passiert nur, falls ein Muster mehrmals direkt hintereinander auftritt. Der Decoder kennt das Muster dann noch nicht, kann den Wert aber rekonstruieren. Dann gilt: Das neue Muster ist das vorherige Muster plus das erste Zeichen des vorherigen Musters.
Beispiel: ABABABA decodieren
- 1Codieren von ABABABA ergibt A B 256 258. Dabei entstehen AB = 256, BA = 257 und ABA = 258
- 2Code A: bekannt, Ausgabe A
- 3Code B: bekannt, Ausgabe B, neuer Eintrag AB = 256
- 4Code 256: bekannt, Ausgabe AB, neuer Eintrag BA = 257
- 5Code 258: nicht bekannt, das ist der Sonderfall
- 6Ausgabe: vorige Ausgabe AB plus ihr erstes Zeichen A, also ABA. Neuer Eintrag ABA = 258
- 7Ergebnis: ABABABA
Merke: Ist ein Code noch nicht im Wörterbuch, dann ist sein Muster die vorige Ausgabe plus ihr erstes Zeichen.
Teste dich
Verlustfrei heißt nicht, dass die Ausgabe kürzer ist. Du musst nachrechnen. Einträge im Wörterbuch werden üblicherweise über einen 12 Bit langen Index angesprochen. Beim Standardverfahren besteht der Datenstrom ausschließlich aus Tabellenindexen. Deshalb sind die Symbole selbst immer genauso groß wie der Tabellenindex. Bei einem 10 Bit langen Index braucht auch ein einzelnes Zeichen 10 Bit, obwohl es ursprünglich 8 Bit waren. Bei dem üblichen 12-Bit-Index sind es entsprechend 12 Bit pro Code.
So prüfst du es: Eingabe = Zahl der Zeichen mal 8 Bit. Ausgabe = Zahl der Codes mal Bits pro Code. Wir rechnen hier mit 12 Bit pro Code, auch für einzelne Zeichen. Das Wikipedia-Beispiel macht es genauso: 16 Codes zu 12 Bit entsprechen 24 Zeichen zu 8 Bit. Die Eingabe hatte dort 22 Zeichen zu 8 Bit. Die codierte Form ist hier also länger.
Es gibt Varianten. Eine speichert ein einzelnes Zeichen meistens direkt mit 8 Bit statt als Verweis mit 12 Bit. Beides unterscheidet sie im Bitstrom per Flag (ein Markierungsbit). Eine andere Verfeinerung beginnt mit 9-Bit-Codes, die später bis zu 12 Bit breit werden.
| Eingabe | Vorher (8 Bit je Zeichen) | Codiert (12 Bit je Code) |
|---|---|---|
| LZWLZ78LZ77LZCLZMWLZAP (22 Zeichen, 16 Codes) | 22 · 8 = 176 Bit | 16 · 12 = 192 Bit |
| ABABABA (7 Zeichen, 4 Codes) | 7 · 8 = 56 Bit | 4 · 12 = 48 Bit |
Merke: Vergleiche immer Bit mit Bit: Zeichen mal 8 mit Codes mal Bits pro Code. Weniger Codes als Zeichen heißt noch nicht weniger Bit.
Teste dich
Alles auf einen Blick
LZW-Kompression
Wörterbuch
Es beginnt mit den Einträgen 0 bis 255 und wächst beim Lesen ab Index 256.
Codieren
Gefundener Eintrag plus nächstes Zeichen wird neuer Eintrag, das Muster wird ausgegeben.
Decodieren
Neuer Eintrag ist das vorherige Muster plus das erste Zeichen des aktuellen Musters.
Sonderfall
Ist der Code noch unbekannt, gilt das vorherige Muster plus dessen erstes Zeichen.
Platz
Zeichen mal 8 Bit mit Codes mal Bits pro Code vergleichen, üblicherweise 12 Bit je Code. Verlustfrei heißt nicht automatisch kürzer.
Musteraufgabe · Schritt für Schritt
ANANAS codieren, decodieren und den Platz prüfen (erfundenes Beispiel)
- 1Am Anfang kennt das Wörterbuch alle einzelnen Zeichen
- 2A, nächstes N: AN fehlt. Ausgabe A, neuer Eintrag AN = 256
- 3N, nächstes A: NA fehlt. Ausgabe N, neuer Eintrag NA = 257
- 4A, dann N: AN ist da, das Muster wird AN. Nächstes A: ANA fehlt. Ausgabe 256, neuer Eintrag ANA = 258
- 5A, nächstes S: AS fehlt. Ausgabe A, neuer Eintrag AS = 259. S bleibt übrig
- 6Ende: Das übrige Muster S wird ausgegeben. Codefolge: A N 256 A S
- 7Decodieren: A ausgeben. N ausgeben, Eintrag AN = 256. Code 256 ist AN: Eintrag NA = 257, Ausgabe AN
- 8Code A: Eintrag ANA = 258, Ausgabe A. Code S: Eintrag AS = 259, Ausgabe S
- 9Zusammen: A, N, AN, A, S ergibt ANANAS
- 10Platz mit 12 Bit je Code: Eingabe 6 · 8 = 48 Bit, Ausgabe 5 · 12 = 60 Bit. Die Codierung ist länger
Fehler finden
Prüfe die Schritte beim Decodieren In einer Zeile steckt ein Fehler. Tippe sie an.
Fehler in Zeile 4Im Sonderfall fehlt das erste Zeichen: Es wird nur die vorige Ausgabe wiederholt. Richtig: vorige Ausgabe A plus ihr erstes Zeichen A, also AA. Insgesamt entsteht AAAA.
Lückentext
Wähl in jeder Lücke das passende Wort und prüf dann deine Antworten.
Die Einträge 0 bis 255 sind schon mit einzelnen Bytes gefüllt, also beginnt der erste neue Eintrag bei . Ist ein Code unbekannt und war die vorige Ausgabe AB, dann ist die Ausgabe ABA. Das angehängte A ist das Zeichen von AB. Der Index hat üblicherweise Bit, das erlaubt maximal 4096 Einträge.
Karteikasten
Erst selbst überlegen, dann umdrehen.
Übung mit Feedback