

Informatik · Klasse 10–13 · aktualisiert
Cache-Speicher: Funktion, Hits und Grenzen erklärt
Du lernst, warum ein Cache die CPU schneller macht, was Hit und Miss sind und warum Schreiben zu veralteten Kopien führen kann.
0 von 11 Aufgaben gelöst
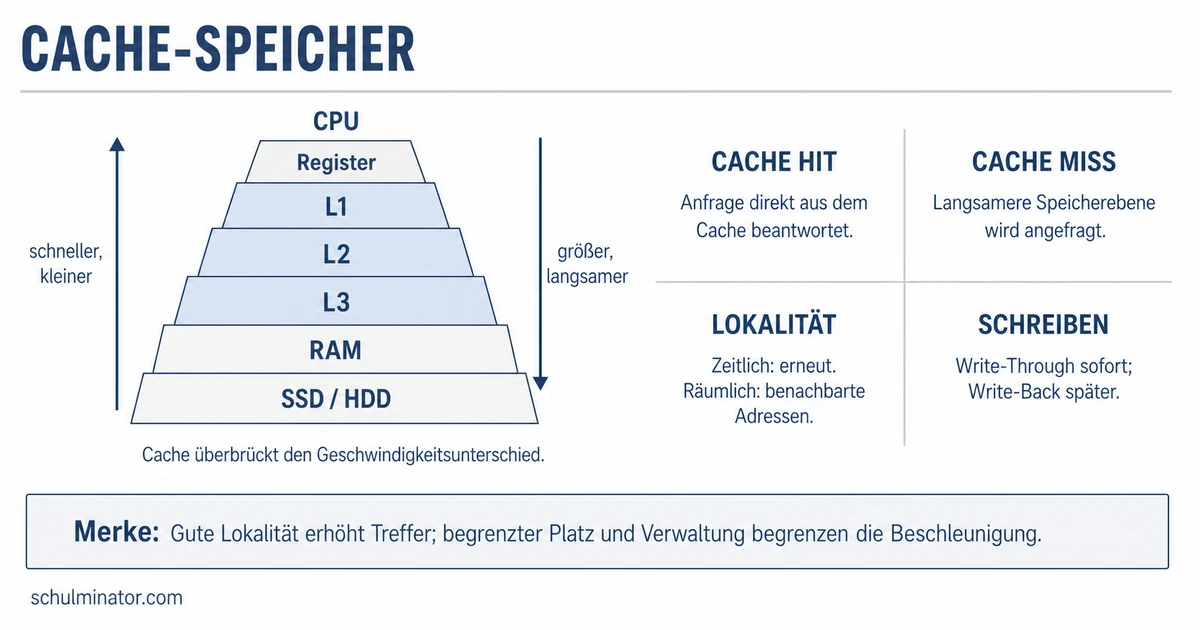
Kurz gesagt
Ein Cache ist ein schneller Pufferspeicher, der Daten aus einem langsameren Speicher bereithält. Bei einem Cache Hit liegen die Daten schon dort, bei einem Cache Miss muss die CPU warten. Das lohnt sich, weil Programme meist mit hoher Wahrscheinlichkeit Daten wiederholt oder aus der Nachbarschaft brauchen.
Dein Prozessor rechnet viel schneller, als der Arbeitsspeicher Daten liefern kann. Ohne Zwischenspeicher würde er oft ausgebremst. Ein Cache löst dieses Problem zum Teil, bringt aber auch eigene Grenzen mit.
Deine Lernziele
Hake ab, was du schon kannst. Löst du alle Aufgaben eines Abschnitts, hakt Mela das Ziel für dich ab.
5 Abschnitte
Ein Cache ist ein schneller Pufferspeicher (ein Zwischenspeicher). Er hilft, wiederholte Zugriffe auf vergleichsweise langsame Datenspeicher zu vermeiden. Daten, die schon einmal geladen wurden, bleiben im Cache und können später schneller abgerufen werden.
In einer Speicherhierarchie (Speicher, geordnet von schnell und klein bis langsam und groß) liegt der Cache zwischen CPU und Arbeitsspeicher. Auf vielen heutigen Computern arbeiten Prozessorregister in der Regel im Takt der CPU, also genauso schnell wie sie. Prozessorcaches brauchen etwa einige Dutzend Taktzyklen (Arbeitsschritte im Takt der CPU), abhängig vom Level, und der Arbeitsspeicher hunderte Taktzyklen. Das Ziel des Caches ist eine kürzere Zugriffszeit und/oder weniger Zugriffe auf das langsame Hintergrundmedium (den langsameren Speicher hinter dem Cache).
Das lohnt sich nur dort, wo die Zugriffszeit die Gesamtleistung deutlich beeinflusst. Bei CPUs kann ein Cache den Flaschenhals der Von-Neumann-Architektur verringern. Die Ausführungsgeschwindigkeit von Programmen kann dadurch im Mittel enorm gesteigert werden.
Definition
Cache
Ein Cache ist ein schneller Pufferspeicher, der (wiederholte) Zugriffe auf vergleichsweise langsame Datenspeicher oder aufwendige Neuberechnungen zu vermeiden hilft.
Beispiel: DNS-Cache
- 1Im Domain Name System wird bei einer Namensauflösung ein Name nachgeschlagen. Das Ergebnis wird vorübergehend in einem lokalen Cache zwischengespeichert.
- 2Folgende identische DNS-Anfragen können aus dem Cache bedient werden.
- 3Der Nameserver muss nicht erneut gefragt werden. Dadurch wird die Performance erhöht.
Merke: Daten, die schon einmal geladen oder erzeugt wurden, bleiben im Cache und sind später schneller abrufbar.
Teste dich
Wenn Daten angefragt werden, wird zuerst im Cache nachgesehen. Liegen die Daten dort, nennt man das Cache Hit (Cachetreffer). Liegen sie nicht dort, nennt man das Cache Miss. Beim Lesen heißen die Fälle Read Hit und Read Miss, beim Schreiben Write Hit und Write Miss. Bei einem Miss muss der Zugreifende warten, bis die Daten vom langsamen Hintergrundmedium geladen wurden.
Die Hit Rate ist die Anzahl der Anfragen mit Hit geteilt durch die Anzahl aller Anfragen an diesen Cache. Sie liegt zwischen 0 und 1. Eine Hit Rate von 0,7 (= 70 %) heißt: Bei 70 % aller Anfragen konnte der Cache die Daten sofort liefern, bei 30 % musste er passen. Die Miss Rate ist analog definiert, und es gilt: Miss Rate = 1 − Hit Rate.
Misses haben verschiedene Ursachen. Ein Capacity Miss tritt auf, wenn der Cache zu klein ist: Daten waren im Cache, wurden wieder entfernt und werden erneut gebraucht. Ein Compulsory Miss ist der erstmalige Zugriff auf eine Adresse, deren Daten noch nicht im Cache sind, während der Cache noch freien Platz hat. Wegen der Misses ist die Ausführungszeit eines Zugriffs nicht immer konstant. Das Zeitverhalten ist also schlecht vorhersagbar.
Definition
Cache Hit und Cache Miss
Bei einem Cache Hit sind die angefragten Daten im Cache vorrätig. Bei einem Cache Miss liegen sie nicht im Cache.
Merke: Miss Rate = 1 − Hit Rate. Beide Größen liegen zwischen 0 und 1.
Teste dich
Die Lokalitätseigenschaft beschreibt typische Computerprogramme: Die Wahrscheinlichkeit ist sehr hoch, dass Daten, die gerade benutzt werden, auch in naher Zukunft wieder benötigt werden. Das gilt für Befehle und für Daten. Man unterscheidet zwei Arten.
Zeitliche Lokalität: Auf Adressbereiche, auf die zugegriffen wird, wird mit hoher Wahrscheinlichkeit auch in naher Zukunft wieder zugegriffen. In Schleifen wird zum Beispiel immer wieder auf dieselben Befehle zurückgegriffen. Deshalb hält ein Cache Daten, auf die erst kürzlich zugegriffen wurde. Alte Daten, die lange nicht benutzt wurden, werden verdrängt. Die LRU-Strategie tauscht dafür den Block aus, auf den am längsten nicht mehr zugegriffen wurde.
Räumliche Lokalität: Nach einem Zugriff auf eine Adresse erfolgt mit hoher Wahrscheinlichkeit der nächste Zugriff auf eine Adresse in unmittelbarer Nachbarschaft. Befehle liegen meist nacheinander im Speicher, wenn kein Sprungbefehl dabei ist. Auch Arrays liegen hintereinander im Speicher. Man kann das ausnutzen, indem man bei einem Zugriff gleich die benachbarten Adressbereiche in die nächste Hierarchiestufe bringt. Cache-Nutzdaten werden in Cache-Lines gespeichert, die heutzutage 64 oder 128 Bytes groß sind.
Grenze: Verarbeitet ein Algorithmus ständig neue Daten (zum Beispiel Streaming-Daten), kann ein Cache keine Beschleunigung durch Mehrfach-Zugriffe bewirken. Allenfalls hilft er geringfügig durch read-ahead, also dadurch, dass Daten, die vermutlich bald gebraucht werden, vorab geladen werden.
Definition
Lokalitätseigenschaft
Sie besagt, dass die Wahrscheinlichkeit sehr hoch ist, dass Daten, die gerade benutzt werden, auch in naher Zukunft wieder benötigt werden. Man unterscheidet zeitliche und räumliche Lokalität.
Beispiel: Schleife über ein Array (ausgedachtes Beispiel)
- 1Eine Schleife addiert die Werte eines Arrays zahlen[0] bis zahlen[9] zu einer Summe.
- 2Die Befehle der Schleife und die Summenvariable werden bei jedem Durchlauf wieder benutzt: zeitliche Lokalität.
- 3Die Werte zahlen[0], zahlen[1], zahlen[2] … liegen hintereinander im Speicher und werden nacheinander gelesen: räumliche Lokalität.
Merke: Zeitlich: dieselbe Adresse wird mit hoher Wahrscheinlichkeit bald wieder benutzt. Räumlich: als Nächstes folgt mit hoher Wahrscheinlichkeit eine Nachbaradresse.
Teste dich
Ein Cache, der sowohl groß als auch schnell ist, ist technisch aufwändig und damit meist wirtschaftlich nicht sinnvoll. Deshalb kann man mehrere Caches verwenden: einen kleinen schnellen und einen deutlich größeren, aber etwas langsameren. Beide sind noch viel schneller als der zu cachende Hintergrundspeicher. So lassen sich geringe Zugriffszeit und großer Cacheumfang gemeinsam erreichen. Das ist wichtig für die Hit Rate.
Mehrere Caches bilden eine Cachehierarchie. Sie werden als L1, L2 usw. durchnummeriert (Level 1, Level 2). Je niedriger die Nummer, desto näher liegt der Cache am schnellen Benutzer. Der L1-Cache hat die schnellste Zugriffszeit und wird als erstes durchsucht. Enthält er die Daten nicht, wird der meist etwas langsamere, aber größere L2-Cache durchsucht usw. Werden die Daten in keiner Ebene gefunden, ist das ein Cache Miss, und es muss auf den langsamen Hintergrundspeicher zugegriffen werden. Vor allem moderne CPUs haben zwei oder drei Cacheebenen.
Grenzen: Schnelle Speicher sind um Größenordnungen teurer als langsamere. Außerdem ist der Hauptprozessor platzbeschränkt und hat einen verhältnismäßig hohen Kühlungsbedarf. Deshalb kann sehr schneller Speicher nur begrenzt eingesetzt werden. Ein Cache lohnt sich zudem nur dort, wo die Zugriffszeit die Gesamtleistung deutlich beeinflusst. Bei Vektorrechnern spielt die Zugriffszeit eine untergeordnete Rolle, deshalb wird dort üblicherweise auf Caches verzichtet. Und wegen der Misses bleibt das Zeitverhalten schlecht vorhersagbar.
| Ebene | Zugriffszeit | Größe |
|---|---|---|
| L1 | am kürzesten, wird zuerst durchsucht | typischerweise klein |
| L2 | meist etwas länger als bei L1 | meist größer als L1 |
| Hintergrundspeicher | viel länger als bei Caches | deutlich größer als ein Cache |
Merke: Je niedriger die Level-Nummer, desto schneller der Cache und desto früher wird er durchsucht.
Teste dich
Wird in einen Block geschrieben, der im Cache vorhanden ist (Write Hit), gibt es zwei Möglichkeiten.
Write-through (Durchschreiben): Die Daten werden sowohl in den Cache als auch in den Hauptspeicher geschrieben. Damit ist normalerweise sichergestellt, dass beide gleich sind. Damit der Prozessor nicht jedes Mal warten muss, nutzt man bei write-through einen Pufferspeicher (write buffer). Wenn dieser voll läuft, muss der Prozessor jedoch anhalten und warten.
Write-back (Rückschreiben): Es wird nicht direkt in den Hauptspeicher geschrieben, sondern erst, wenn der entsprechende Cache-Block ersetzt werden muss. Ein Dirty-Bit zeigt an, welche Daten noch nicht im Hauptspeicher stehen. Write-back ist technisch anspruchsvoller, aber schneller als write-through.
Das Problem: Beim write-back sind Cache und Hauptspeicher vorübergehend inkonsistent, der Hauptspeicher enthält veraltete Information. Bei Multiprozessorsystemen hat üblicherweise jeder Prozessor seinen eigenen Cache und greift darüber auf einen gemeinsamen Speicher zu. Cache-Kohärenz sorgt dafür, dass die Caches für dieselbe Speicheradresse nicht unterschiedliche Daten zurückliefern. Eine temporäre Inkonsistenz ist zulässig, wenn sie spätestens bei lesenden Zugriffen identifiziert und behoben wird. Ein Weg dahin ist das Write-Invalidate-Protokoll: Vor dem Verändern einer Kopie müssen alle Kopien in anderen Caches für ungültig erklärt werden.
Definition
Dirty-Bit
Das Dirty-Bit zeigt bei write-back an, dass Daten im Cache und im Hauptspeicher inkonsistent sind. Ist es gesetzt, stehen die Daten noch nicht im Hauptspeicher.
| Merkmal | Write-through | Write-back |
|---|---|---|
| Hauptspeicher bei Write Hit | wird sofort mit beschrieben | erst beim Ersetzen des Blocks |
| Cache und Hauptspeicher | normalerweise gleich | vorübergehend inkonsistent |
| Geschwindigkeit | langsamer | schneller |
Merke: Beim write-back kann der Hauptspeicher vorübergehend veraltet sein. Cache-Kohärenz verhindert, dass Caches für dieselbe Adresse verschiedene Daten liefern.
Teste dich
Alles auf einen Blick
Cache-Speicher
Cache
Schneller Pufferspeicher, der wiederholte Zugriffe auf langsamere Speicher vermeiden hilft
Hit und Miss
Beim Hit liegen die Daten im Cache, beim Miss nicht. Miss Rate = 1 − Hit Rate
Lokalität
Zeitlich wird dieselbe Adresse bald wieder benutzt, räumlich folgt eine Nachbaradresse, jeweils mit hoher Wahrscheinlichkeit
Cachehierarchie
L1 wird zuerst durchsucht, größere Ebenen folgen. Schneller Speicher ist teuer und platzbegrenzt
Schreibstrategien
Write-through hält Cache und Hauptspeicher normalerweise gleich, write-back ist schneller, aber vorübergehend inkonsistent
Kohärenz
Bei mehreren Caches muss ein Algorithmus verhindern, dass sie für dieselbe Adresse verschiedene Daten liefern
Musteraufgabe · Schritt für Schritt
Einen Wert mit write-back ändern (ausgedachtes Beispiel)
- 1Annahme: Adresse A enthält den Wert 5, im Cache und im Hauptspeicher. Der Cache nutzt write-back.
- 2Schritt 1: Das Programm schreibt 7 nach A. Der Block ist im Cache, also ein Write Hit.
- 3Schritt 2: Nur der Cache bekommt 7. Der Hauptspeicher enthält weiter 5, das Dirty-Bit wird gesetzt.
- 4Schritt 3: Liest jetzt ein anderer Prozessor A aus dem Hauptspeicher, sieht er den veralteten Wert 5. Das ist das Problem der Inkonsistenz.
- 5Schritt 4: Wird der Block ersetzt, wird 7 in den Hauptspeicher geschrieben. Dann stehen beide auf 7.
- 6Zum Vergleich: Bei write-through hätten Cache und Hauptspeicher schon in Schritt 2 beide 7 enthalten.
Fehler finden
Prüfe die Aussagen zu zwei Prozessoren mit eigenem Cache (ausgedachtes Beispiel) In einer Zeile steckt ein Fehler. Tippe sie an.
Fehler in Zeile 3Das ist falsch, weil der Hauptspeicher bei write-back nicht sofort aktualisiert wird. Richtig: Er wird erst beschrieben, wenn der Cache-Block ersetzt werden muss, bis dahin ist er veraltet.
Lückentext
Wähl in jeder Lücke das passende Wort und prüf dann deine Antworten.
Liegt die Hit Rate bei 0,9, beträgt die Miss Rate . Wird dieselbe Adresse in einer Schleife immer wieder gelesen, nutzt der Cache die Lokalität. Bei steht ein geänderter Block zunächst nur im Cache, ein gesetztes Dirty-Bit zeigt das an.
Karteikasten
Erst selbst überlegen, dann umdrehen.
Übung mit Feedback