

Informatik · Klasse 9–13 · aktualisiert
Tiefensuche (DFS): Ablauf, Stack und Beispiele
Du führst die Tiefensuche Schritt für Schritt aus, verstehst Besuchsmarkierung und Stack und vergleichst sie mit der Breitensuche.
0 von 11 Aufgaben gelöst
Kurz gesagt
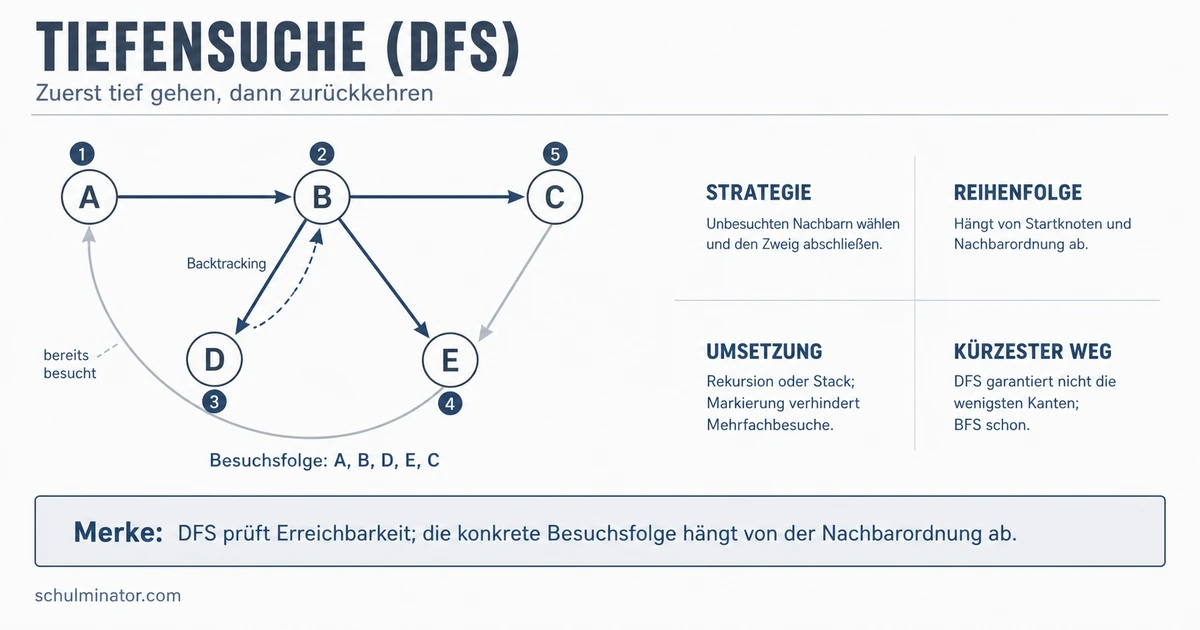
Die Tiefensuche (DFS) geht von einem Startknoten aus zuerst einen Pfad ganz in die Tiefe. Geht es nicht weiter, geht sie zurück und probiert den nächsten Nachbarn. Sie markiert besuchte Knoten und nutzt Rekursion oder einen Stack. Einen kürzesten Weg garantiert sie nicht.
Stell dir vor, du suchst den Ausweg aus einem Irrgarten. Du folgst einem Gang, bis es nicht mehr weitergeht, und gehst dann zurück zur letzten Abzweigung. Genau so arbeitet die Tiefensuche. Mit ihr lassen sich zum Beispiel Rätsel mit nur einer Lösung wie Irrgärten lösen.
Deine Lernziele
Hake ab, was du schon kannst. Löst du alle Aufgaben eines Abschnitts, hakt Mela das Ziel für dich ab.
3 Abschnitte
Ein Graph besteht aus Knoten (Punkten) und Kanten (Verbindungen zwischen Knoten). Die Tiefensuche (englisch depth-first search, kurz DFS) durchsucht einen Graphen so: Sie startet bei einem Startknoten und geht zuerst einen Pfad ganz in die Tiefe, bevor sie zu abzweigenden Pfaden kommt.
So gehst du vor: Erstens gehst du vom aktuellen Knoten zum ersten Nachbarn, der noch nicht entdeckt ist. Zweitens rufst du dort dieselbe Suche noch einmal auf (rekursiv). Drittens: Hat ein Knoten keinen weiteren Nachfolger mehr, geht die Suche Schritt für Schritt zum Vorgänger zurück und versucht es dort mit dem nächsten Nachbarn.
Welcher Nachbar der „erste“ ist, hängt von der Darstellung des Graphen ab. Bei einer Adjazenzliste (für jeden Knoten eine Liste seiner Nachbarn) als verkettete Liste kommen die Nachbarn in der Reihenfolge ihres Eintrags in der Liste dran. Bei einer Aufgabe ist die Nachbarreihenfolge deshalb eine Vorgabe, die du genau einhalten musst.
Mit einem anderen Startknoten oder bei einem gerichteten Graphen (die Kanten haben eine Richtung), der nicht symmetrisch ist, kann sich die Reihenfolge der durchlaufenen Knoten ändern.
Definition
Tiefensuche
Ein Verfahren zum Suchen von Knoten in einem Graphen. Dabei wird zunächst ein Pfad vollständig in die Tiefe beschritten, bevor abzweigende Pfade beschritten werden.
Beispiel: Tiefensuche von S aus, Nachbarn in der angegebenen Reihenfolge
- 1Ungerichteter Graph. Nachbarn in dieser Reihenfolge: S: C, A · A: S, B, D · B: A, C, E
- 2C: S, B · D: A, E · E: B, D · F: G · G: F
- 3S besuchen. Der erste Nachbar C ist neu: C besuchen.
- 4C hat die Nachbarn S und B. S ist schon besucht, also B besuchen.
- 5B: Der erste Nachbar A ist neu: A besuchen. A: S und B sind besucht, D ist neu: D besuchen.
- 6D: A ist besucht, E ist neu: E besuchen. E hat nur die besuchten Nachbarn B und D: E ist fertig.
- 7Zurück über D, A, B und C bis S: Dabei findet keiner dieser Knoten einen neuen Nachbarn. Auch A, der zweite Nachbar von S, ist schon besucht.
- 8Besuchsreihenfolge: S C B A D E. F und G werden von S aus nicht erreicht.
Merke: Erst ganz in die Tiefe, dann Schritt für Schritt zurück: Zurück geht die Suche nur, wenn ein Knoten keinen weiteren Nachfolger mehr hat.
Teste dich
Die Besuchsmarkierung: In vielen Graphen gibt es Kreise (Zyklen). Dann kommt man über Kanten zu einem Knoten zurück, an dem man schon war. Wird kein Test auf Zyklen gemacht, ist die Tiefensuche nicht vollständig: Ein Ergebnis, das es gibt, kann dann unentdeckt bleiben. Deshalb wird ein Knoten beim Besuch als besucht markiert. In einer Java-Umsetzung geht die Suche nur zu Knoten weiter, die erreichbar und noch nicht besucht sind. Auch das Ende eines Aufrufs hängt daran: Er endet, wenn der Knoten nur Nachbarn hat, die schon vorher durchlaufen wurden.
Der Weg zurück: Wenn ein Knoten keine neuen Nachbarn mehr hat, muss die Suche zum Vorgänger zurück. Dafür muss sie sich merken, über welche Knoten sie gekommen ist. Ein Stack (deutsch Stapel) ist dafür geeignet: Elemente können nur oben aufgelegt (push) und nur von dort wieder genommen werden (pop). Sie kommen in umgekehrter Reihenfolge wieder heraus (englisch Last-In-First-Out).
Bei Rekursion übernimmt der Stack des Programms diese Aufgabe: Jede aufgerufene Prozedur legt ihre Rückgabeinformationen und lokalen Daten auf den Stack, beim Aufruf eines Unterprogramms auch die Rücksprungadresse. Das erlaubt Rekursion, also den Aufruf einer Funktion aus ihr selbst heraus.
Wandelt man ein rekursives Unterprogramm in ein iteratives um, muss dieser Mechanismus häufig ausdrücklich selbst umgesetzt werden. Eine iterative Tiefensuche speichert dann in einem Stack den bereits entdeckten Weg bis zu einem Knoten ohne neuen Nachbarn. Der Stack wird abgetragen, bis ein gespeicherter Knoten noch einen weiteren neuen Nachbarn hat oder der Stack leer ist. Damit wird das Zurückgehen der Rekursion nachgebildet.
Definition
Stack (Stapel)
Eine Datenstruktur, bei der Elemente nur oben aufgelegt und auch nur von dort gelesen werden können. Die Operation pop liefert das oberste Objekt und entfernt es vom Stack.
Beispiel: Ohne Markierung? (Gedankenspiel)
- 1Im Graphen von oben gilt: Der erste Nachbar von S ist C, der erste Nachbar von C ist S.
- 2Angenommen, nichts wird markiert und die Suche geht immer zum ersten Nachbarn.
- 3S → C. Der erste Nachbar von C ist S, also wieder S.
- 4Der erste Nachbar von S ist C, also wieder C, und so weiter.
- 5Das ist eine Schlussfolgerung: Die Suche kreist, und E wird nie erreicht, obwohl es von S aus erreichbar ist.
Merke: Die Markierung verhindert, dass die Suche im Kreis läuft. Der Stack oder die Rekursion liefert den Weg zurück zum Vorgänger.
Teste dich
Erreichbarkeit: Die Tiefensuche soll alle erreichbaren Knoten des Graphen besuchen. Auch die Breitensuche (englisch breadth-first search, kurz BFS) findet alle Knoten des Teils vom Graphen, in dem der Startknoten liegt (Fachwort: Zusammenhangskomponente). Im Beispiel bleiben F und G bei beiden Verfahren unerreicht, weil sie nur miteinander verbunden sind und nicht mit S.
Der Unterschied liegt im Vorgehen: Die Breitensuche besucht zuerst alle Knoten, die vom Startknoten direkt erreichbar sind, und erst danach die Folgeknoten. Dafür nimmt sie den ersten Knoten aus einer Warteschlange und hängt dessen noch nicht markierte Nachfolger hinten an. Die Tiefensuche folgt dagegen zuerst einem Pfad in die Tiefe.
Kürzeste Wege: Jede durch Breitensuche gefundene Lösung hat den kürzesten Abstand zum Wurzelknoten. Mit ihr findest du bei ungewichteten Kanten einen kürzesten Pfad zwischen zwei Knoten. Sind den Kanten Gewichte zugeordnet, muss das Ergebnis, das dem Start am nächsten liegt, nicht das mit den geringsten Pfadkosten sein. Die Tiefensuche ist bei monoton steigenden Pfadkosten (Kosten, die entlang eines Pfades nicht sinken) nicht optimal, weil eventuell ein Ergebnis gefunden wird, zu dem ein sehr viel längerer Pfad führt als zu einem anderen.
Die Laufzeit unterscheidet die beiden nicht: Bei beiden beträgt sie O(|V|+|E|). Dabei ist |V| die Zahl der Knoten und |E| die Zahl der Kanten. Die Tiefensuche ist also nicht schon deshalb schneller.
Definition
Breitensuche (BFS)
Ein Verfahren, das zuerst alle Knoten besucht, die vom Ausgangsknoten direkt erreichbar sind, und erst danach die Folgeknoten.
| Verfahren | Besuchsreihenfolge ab S | Weg von S zu E |
|---|---|---|
| Tiefensuche | S C B A D E | S → C → B → A → D → E (5 Kanten) |
| Breitensuche | S C A B D E | S → C → B → E (3 Kanten) |
Merke: Beide Verfahren besuchen die erreichbaren Knoten. Bei ungewichteten Kanten findet die Breitensuche einen kürzesten Pfad. Beim Tiefensuche-Weg ist das nicht garantiert.
Teste dich
Alles auf einen Blick
Tiefensuche
Tiefensuche
zuerst ein Pfad ganz in die Tiefe, dann Schritt für Schritt zurück
Nachbarreihenfolge
eine Vorgabe, sie hängt von der Darstellung des Graphen ab
Besuchsmarkierung
verhindert, dass die Suche im Kreis läuft
Stack oder Rekursion
speichert den Weg und führt zum Vorgänger zurück
Breitensuche
findet bei ungewichteten Kanten einen kürzesten Pfad
Tiefensuche
garantiert keinen kürzesten Weg, beide Verfahren haben die Laufzeit O(|V|+|E|)
Musteraufgabe · Schritt für Schritt
Tiefensuche in einem ausgedachten Graphen (erfundenes Beispiel)
- 1Ausgedachter ungerichteter Graph, Nachbarn in dieser Reihenfolge: P: Q, R · Q: P, T · R: P, T · T: Q, R, U · U: T
- 2Start P. P besuchen. Der erste Nachbar Q ist neu: Q besuchen.
- 3Q hat die Nachbarn P und T. P ist besucht, T ist neu: T besuchen.
- 4T hat die Nachbarn Q, R und U. Q ist besucht, R ist neu: R besuchen.
- 5R hat die Nachbarn P und T. Beide sind besucht, R ist fertig. Zurück zu T.
- 6T: Der nächste Nachbar U ist neu: U besuchen. U hat nur den besuchten Nachbarn T und ist fertig.
- 7Zurück über T und Q bis P. P hat R als zweiten Nachbarn, doch R ist schon besucht.
- 8Besuchsreihenfolge: P Q T R U. Probe: Jeder der fünf Knoten kommt genau einmal vor.
Fehler finden
Prüfe die Schritte dieser Tiefensuche (ausgedachtes Beispiel) In einer Zeile steckt ein Fehler. Tippe sie an.
Fehler in Zeile 4Der Fehler: W wurde erneut besucht, obwohl er schon markiert ist. Richtig: Y geht nur zu Nachbarn, die noch nicht besucht sind. W und X sind besucht, also kommt Z als Nächster dran.
Lückentext
Wähl in jeder Lücke das passende Wort und prüf dann deine Antworten.
Bei einem Stack legst du ein Element nur auf, und pop holt das Element von dort wieder. Hat ein Knoten nur noch besuchte Nachbarn, geht die Suche Schritt für Schritt zum zurück. Die Breitensuche nimmt den ersten Knoten der Warteschlange heraus und hängt neue Nachbarn am der Warteschlange an.
Karteikasten
Erst selbst überlegen, dann umdrehen.
Übung mit Feedback