Wikipedia · einfach zusammengefasst · Stand
Merge-Algorithmen
Merge-Algorithmen werden in vielen Algorithmen als Unterprogramm verwendet. Ein bekanntes Beispiel dafür ist Mergesort.
Inhalt6 Abschnitte
Grundidee und Einsatz
Merge-Algorithmen sind eine Familie von Algorithmen, die mehrere bereits sortierte Listen als Eingabe bekommen und daraus eine einzige sortierte Liste erzeugen. Diese Ausgabeliste enthält alle Elemente der Eingabelisten. Wichtig sind Merge-Algorithmen vor allem als Unterprogramm in anderen Algorithmen. Das bekannteste Beispiel ist Mergesort, ein vergleichsbasierter Sortieralgorithmus.
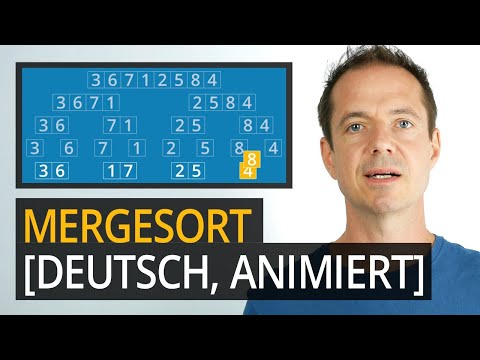
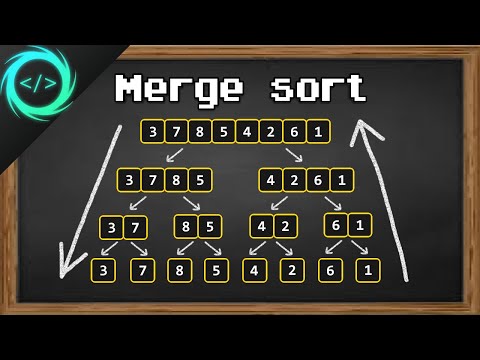
Bei Mergesort wird die Eingabe zuerst rekursiv in kürzere Listen von ungefähr gleicher Länge geteilt, bis jede Liste nur noch ein Element enthält. Eine Liste mit nur einem Element gilt nach Definition als sortiert. Danach werden die kurzen sortierten Listen wiederholt verschmolzen, bis eine einzelne sortierte Liste übrig ist. Der Merge-Algorithmus wird dabei immer wieder ausgeführt. In einem Beispiel mit 7 Zahlen wird das Array zunächst in 7 Partitionen mit je einem Element aufgeteilt; anschließend werden diese sortierten Teillisten schrittweise zu längeren sortierten Listen verschmolzen.
Zwei Listen verschmelzen
Das Verschmelzen von zwei sortierten Listen ist der einfachste Fall. Es kann in linearer Zeitkomplexität und mit linearem Platz durchgeführt werden. Linear bedeutet hier: Die benötigte Zeit wächst proportional zur Gesamtzahl der Elemente.
Der Grundablauf ist: Man betrachtet jeweils den Kopf, also das erste Element, der beiden Listen A und B. Ist kopf(A) ≤ kopf(B), wird kopf(A) an die Ausgabeliste C angehängt und aus A entfernt. Andernfalls wird kopf(B) an C angehängt und aus B entfernt. Das wird wiederholt, solange beide Listen noch Elemente enthalten. Wenn eine der beiden Listen leer ist, werden die restlichen Elemente der anderen Liste an C angehängt.
Das Entfernen des ersten Elements wird in einer typischen Implementierung nicht unbedingt durch echtes Löschen umgesetzt, sondern oft durch das Inkrementieren eines Pointers, also durch das Weiterschieben einer Positionsmarke. Das Erstellen einer neuen Liste C kann vermieden werden, macht den Algorithmus laut Artikel aber langsamer und schwerer zu verstehen.
k-Wege-Mischen
Beim k-Wege-Mischen werden k sortierte Listen zu einer einzigen sortierten Liste verschmolzen. Die Ausgabeliste enthält genau die gleichen Elemente wie die Ursprungslisten. Sei n die Gesamtzahl der Elemente. Dann ist n zugleich die Größe der Ausgabeliste und die Summe der Größen aller Eingabelisten.
Das Problem kann mit einer Laufzeit von O(n log k) und einem Platzbedarf von O(n) gelöst werden. Die O-Notation beschreibt dabei eine obere Schranke für das Wachstum von Laufzeit oder Speicherbedarf. Es gibt verschiedene Verfahren.
Beim direkten k-Wege-Mischen wird in jedem Schritt das kleinste Element unter den k Listen gesucht und an die Ausgabe angehängt. Eine naive Implementierung durchsucht in jedem Schritt alle k Listen, um das Minimum zu finden. Diese Lösung hat eine Laufzeit von Θ(kn) und ist deshalb nicht besonders effizient.
Effizienter wird das Verfahren, wenn das kleinste Element schneller gefunden wird. Mit Heaps oder Turnierbäumen kann das kleinste Element in O(log k) gefunden werden. Dann ergibt sich insgesamt eine Laufzeit von O(n log k). Heaps werden in der Praxis häufig verwendet, Turnierbäume haben aber eine etwas bessere Vergleichszahl: Ein Heap benötigt etwa 2*log(k) Vergleiche pro Schritt, weil er den Baum von der Wurzel nach unten zu den Blättern bearbeitet. Ein Turnierbaum benötigt nur log(k) Vergleiche, weil er unten beginnt und sich mit einem Vergleich pro Ebene zur Wurzel hocharbeitet.
Heap und Turnierbaum
Der Heap-Algorithmus verwendet einen min-Heap mit Zeigern auf die Eingabelisten. Ein min-Heap ist eine Datenstruktur, bei der das kleinste Element an der Wurzel steht. Die Zeiger werden nach dem Element sortiert, auf das sie zeigen. Der Heap wird mit einem heapify-Algorithmus in O(k) aufgebaut. Danach wird wiederholt das Element, auf das der Wurzel-Zeiger zeigt, in die Ausgabe geschrieben. Anschließend wird ein increaseKey-Algorithmus auf dem Heap ausgeführt. Dieser braucht O(log k). Da insgesamt n Elemente verschmolzen werden, ergibt sich O(n log k).
Ein Turnierbaum, auch tournament tree, funktioniert wie ein K.-o.-Turnier. In jedem Spiel treten zwei Eingabeelemente gegeneinander an. Da aufsteigend sortiert wird, gewinnt jeweils das kleinere Element und wird nach oben weitergegeben. So entsteht ein Binärbaum aus Vergleichen.
Für k-Wege-Mischen ist eine Variante besonders effizient: der Verlierer-Baum oder Loser tree. Dabei wird in jedem inneren Knoten nicht der Gewinner, sondern der Verlierer eines Spiels gespeichert. Der Gewinner wird beim Aufbau oder beim Ersetzen eines Elements trotzdem nach oben weitergegeben. Oberhalb der Wurzel wird normalerweise ein zusätzlicher Knoten eingefügt, der den gesamten Gewinner speichert.
Jedes Blatt enthält einen Zeiger auf eine Eingabeliste. Jeder innere Knoten speichert einen Wert und einen Zeiger zu einer Eingabeliste; der Wert ist eine Kopie des ersten Elements dieser Liste. Der Algorithmus hängt wiederholt das kleinste Element an die Ausgabeliste an und entfernt es aus der zugehörigen Eingabeliste. Danach werden auf dem Pfad vom aktualisierten Blatt zur Wurzel die Spiele neu ausgetragen. Dieser Vorgang heißt replacement selection. Weil im Verlierer-Baum die Gegner der letzten Runde bereits gespeichert sind, muss das neue Element nur gegen diese Verlierer antreten.
Laufzeit und Beispiel
Ein Turnierbaum kann als perfekter Binärbaum dargestellt werden. Dazu können an Listen Sentinels angefügt werden, und die Anzahl der Eingabelisten kann durch leere Listen zu einer Zweierpotenz erweitert werden. Dann lässt sich der Baum in einem einzelnen Array speichern; das Eltern-Element erreicht man, indem man den aktuellen Index durch 2 teilt.
Der Aufbau des Baums benötigt Θ(k). Wenn ein Blatt aktualisiert wird, werden alle Spiele von diesem Blatt bis zur Wurzel neu ausgetragen. Pro Ebene ist nur ein Vergleich nötig. Da der Baum balanciert ist, hat der Pfad von der Eingabeliste zur Wurzel Θ(log k) Elemente. Weil insgesamt n Elemente übertragen werden, liegt die Gesamtlaufzeit bei Θ(n log k).
Ein Beispiel im Artikel nutzt vier sortierte Arrays: {2, 7, 16}, {5, 10, 20}, {3, 6, 21} und {4, 8, 9}. Der Algorithmus beginnt mit den Köpfen dieser Listen und baut daraus einen Verlierer-Baum. Das kleinste Element ist zunächst 2. Es wird entfernt und durch den Nachfolger 7 ersetzt. Danach werden die Spiele bis zur Wurzel neu ausgetragen. Als nächstes wird 3 entfernt und durch 6 ersetzt. Dieser Vorgang wird wiederholt, bis das gesamte Minimum oberhalb der Wurzel unendlich beträgt.
In der Laufzeitanalyse wird außerdem gezeigt, dass kein vergleichsbasierter Algorithmus zum k-Wege-Mischen schneller als O(n log k) sein kann. Der Beweis geschieht durch Reduktion auf vergleichsbasiertes Sortieren: Wenn k = n Listen mit je einem Element verschmolzen würden und das schneller als O(n log k) ginge, könnte man schneller als O(n log n) sortieren. Das widerspricht der bekannten unteren Schranke O(n log n) für vergleichsbasiertes Sortieren im worst-case.
Paralleles Mischen
Eine parallele Version des binären Mischens kann als Baustein für parallelen Mergesort dienen. Der beschriebene Teile-und-Herrsche-Algorithmus arbeitet auf zwei sortierten Arrays A und B und schreibt das sortierte Ergebnis in ein Array C. Die Notation A[i...j] bezeichnet den Teil von A von Index i bis exklusive j.
Der Algorithmus stellt zuerst sicher, dass A das größere Array ist. Wenn m die Länge von A und n die Länge von B ist und m < n gilt, werden A und B sowie m und n getauscht. Ist m ≤ 0, ist nichts zu mischen. Sonst wird A in der Mitte geteilt: r = ⌊(i + j)/2⌋. Mit binary-search(A[r], B[k...ℓ]) wird der Index s in B gesucht, an dem A[r] eingefügt würde. Daraus wird die Zielposition t in C berechnet, und C[t] = A[r] gesetzt. Danach werden die linke und rechte Hälfte rekursiv gemischt. Diese beiden rekursiven Aufrufe sind unabhängig und können parallel ausgeführt werden.
Die Arbeit für das Mischen von zwei Arrays mit insgesamt n Elementen beträgt O(n). Das ist optimal, weil mindestens n Elemente in C kopiert werden müssen. Für den Span, also die Laufzeit auf einer idealen Maschine mit unbegrenzt vielen Prozessoren, ergibt sich im schlimmsten Fall die Rekurrenz T∞^merge(n)=T∞^merge(3/4 n)+Θ(log(n)). Ihre Lösung ist T∞^merge(n)=Θ(log(n)^2).
Der Artikel weist darauf hin, dass diese parallele Mischroutine nicht stabil ist. Stabil bedeutet, dass gleiche Elemente ihre ursprüngliche Reihenfolge behalten. Hier können gleiche Elemente beim Aufteilen von A und B getrennt werden und sich in C verschränken; außerdem kann das Tauschen von A und B die Ordnung zerstören, wenn gleiche Items über beide Eingabearrays verteilt sind.